


テンセントのメディア AI モデル WAND を全面公開。メディアクリエイティブを、発想から納品までワンストップで実現します

WAND
Enhance+
EraseVibe+
Vega
Codec+
Vega VL
Vega Audio
画質向上モデル
WAND-Enhance+ は、DiTベースの大規模モデルを採用した高性能な画質向上モデルです。グローバルなコンテキスト情報を活用し、質感や細部を自然に再構築することで、映像の鮮明さと透明感を高いレベルで向上させます。
4K超解像、最大120FPSのインテリジェントフレーム補間、圧縮ノイズ除去、SDRからHDRへの変換、顔補正など、多彩な画質向上機能に対応しています。
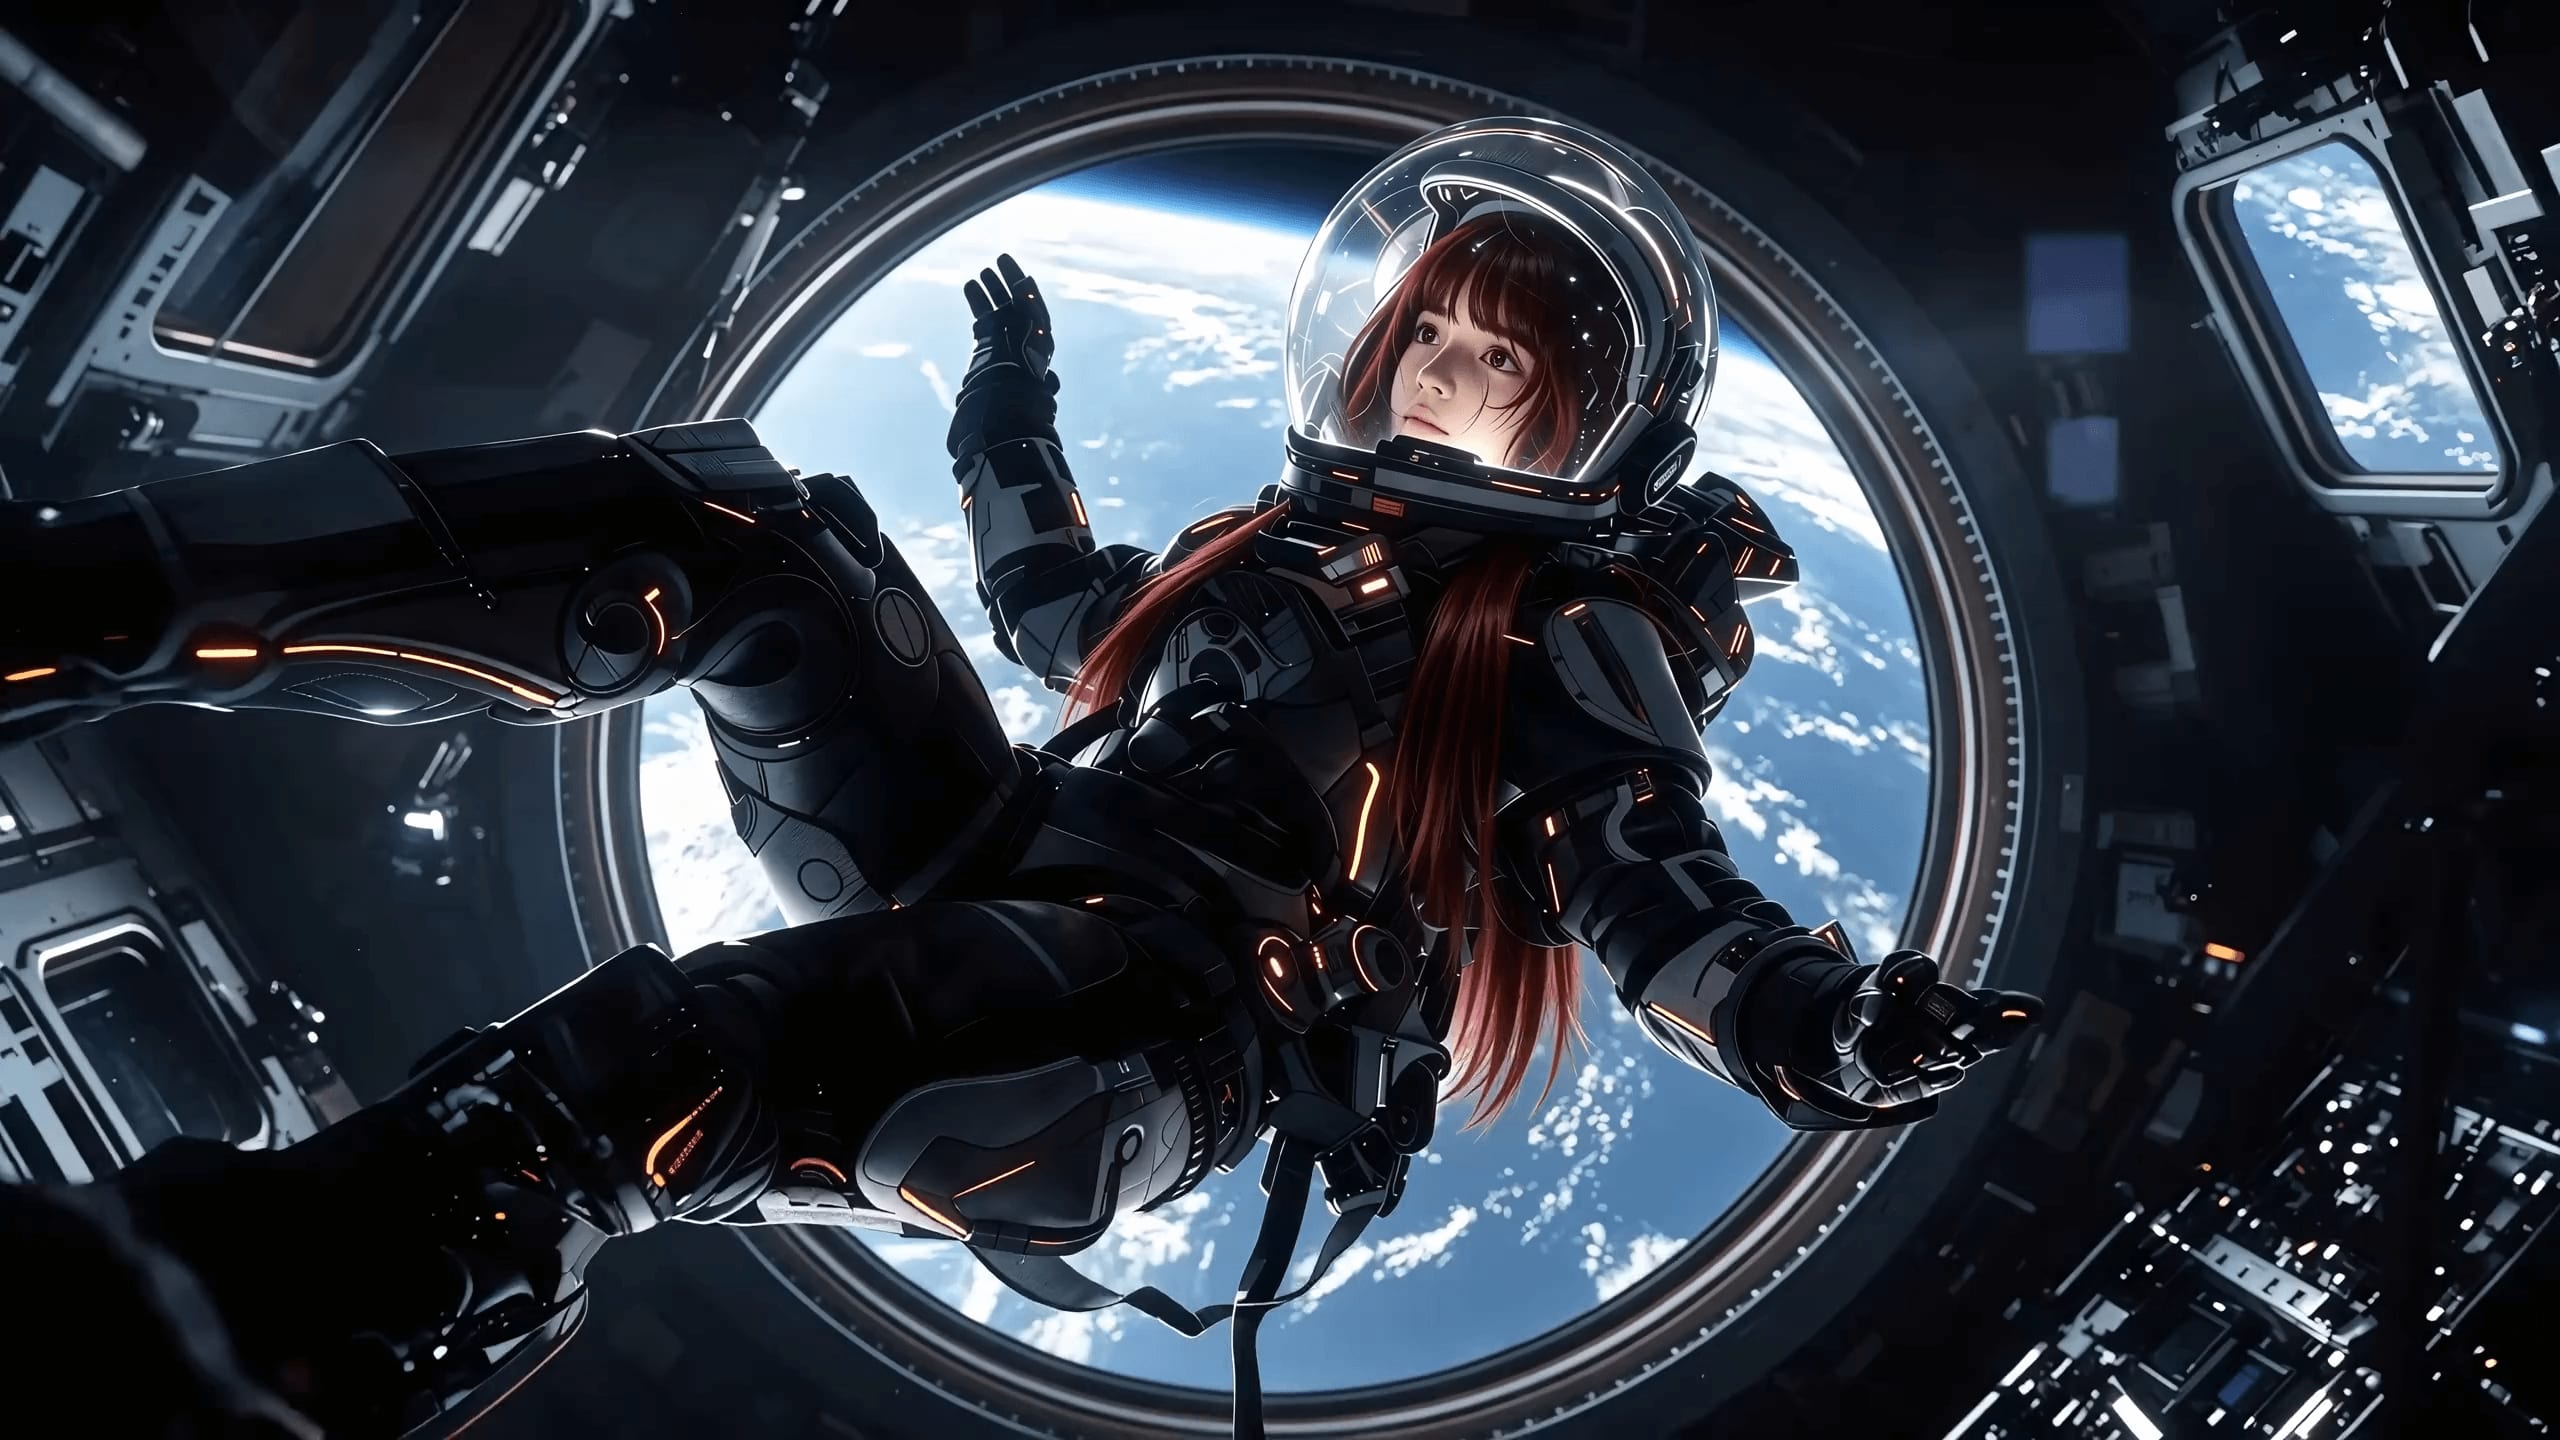
女性が中庭でゆっくりと目を開けると同時に太極拳を始め、拳が起こす風が落ち葉を巻き上げる。画面は同じ画風を維持すること
 WAND-Vega
映像パラメータH.2644K
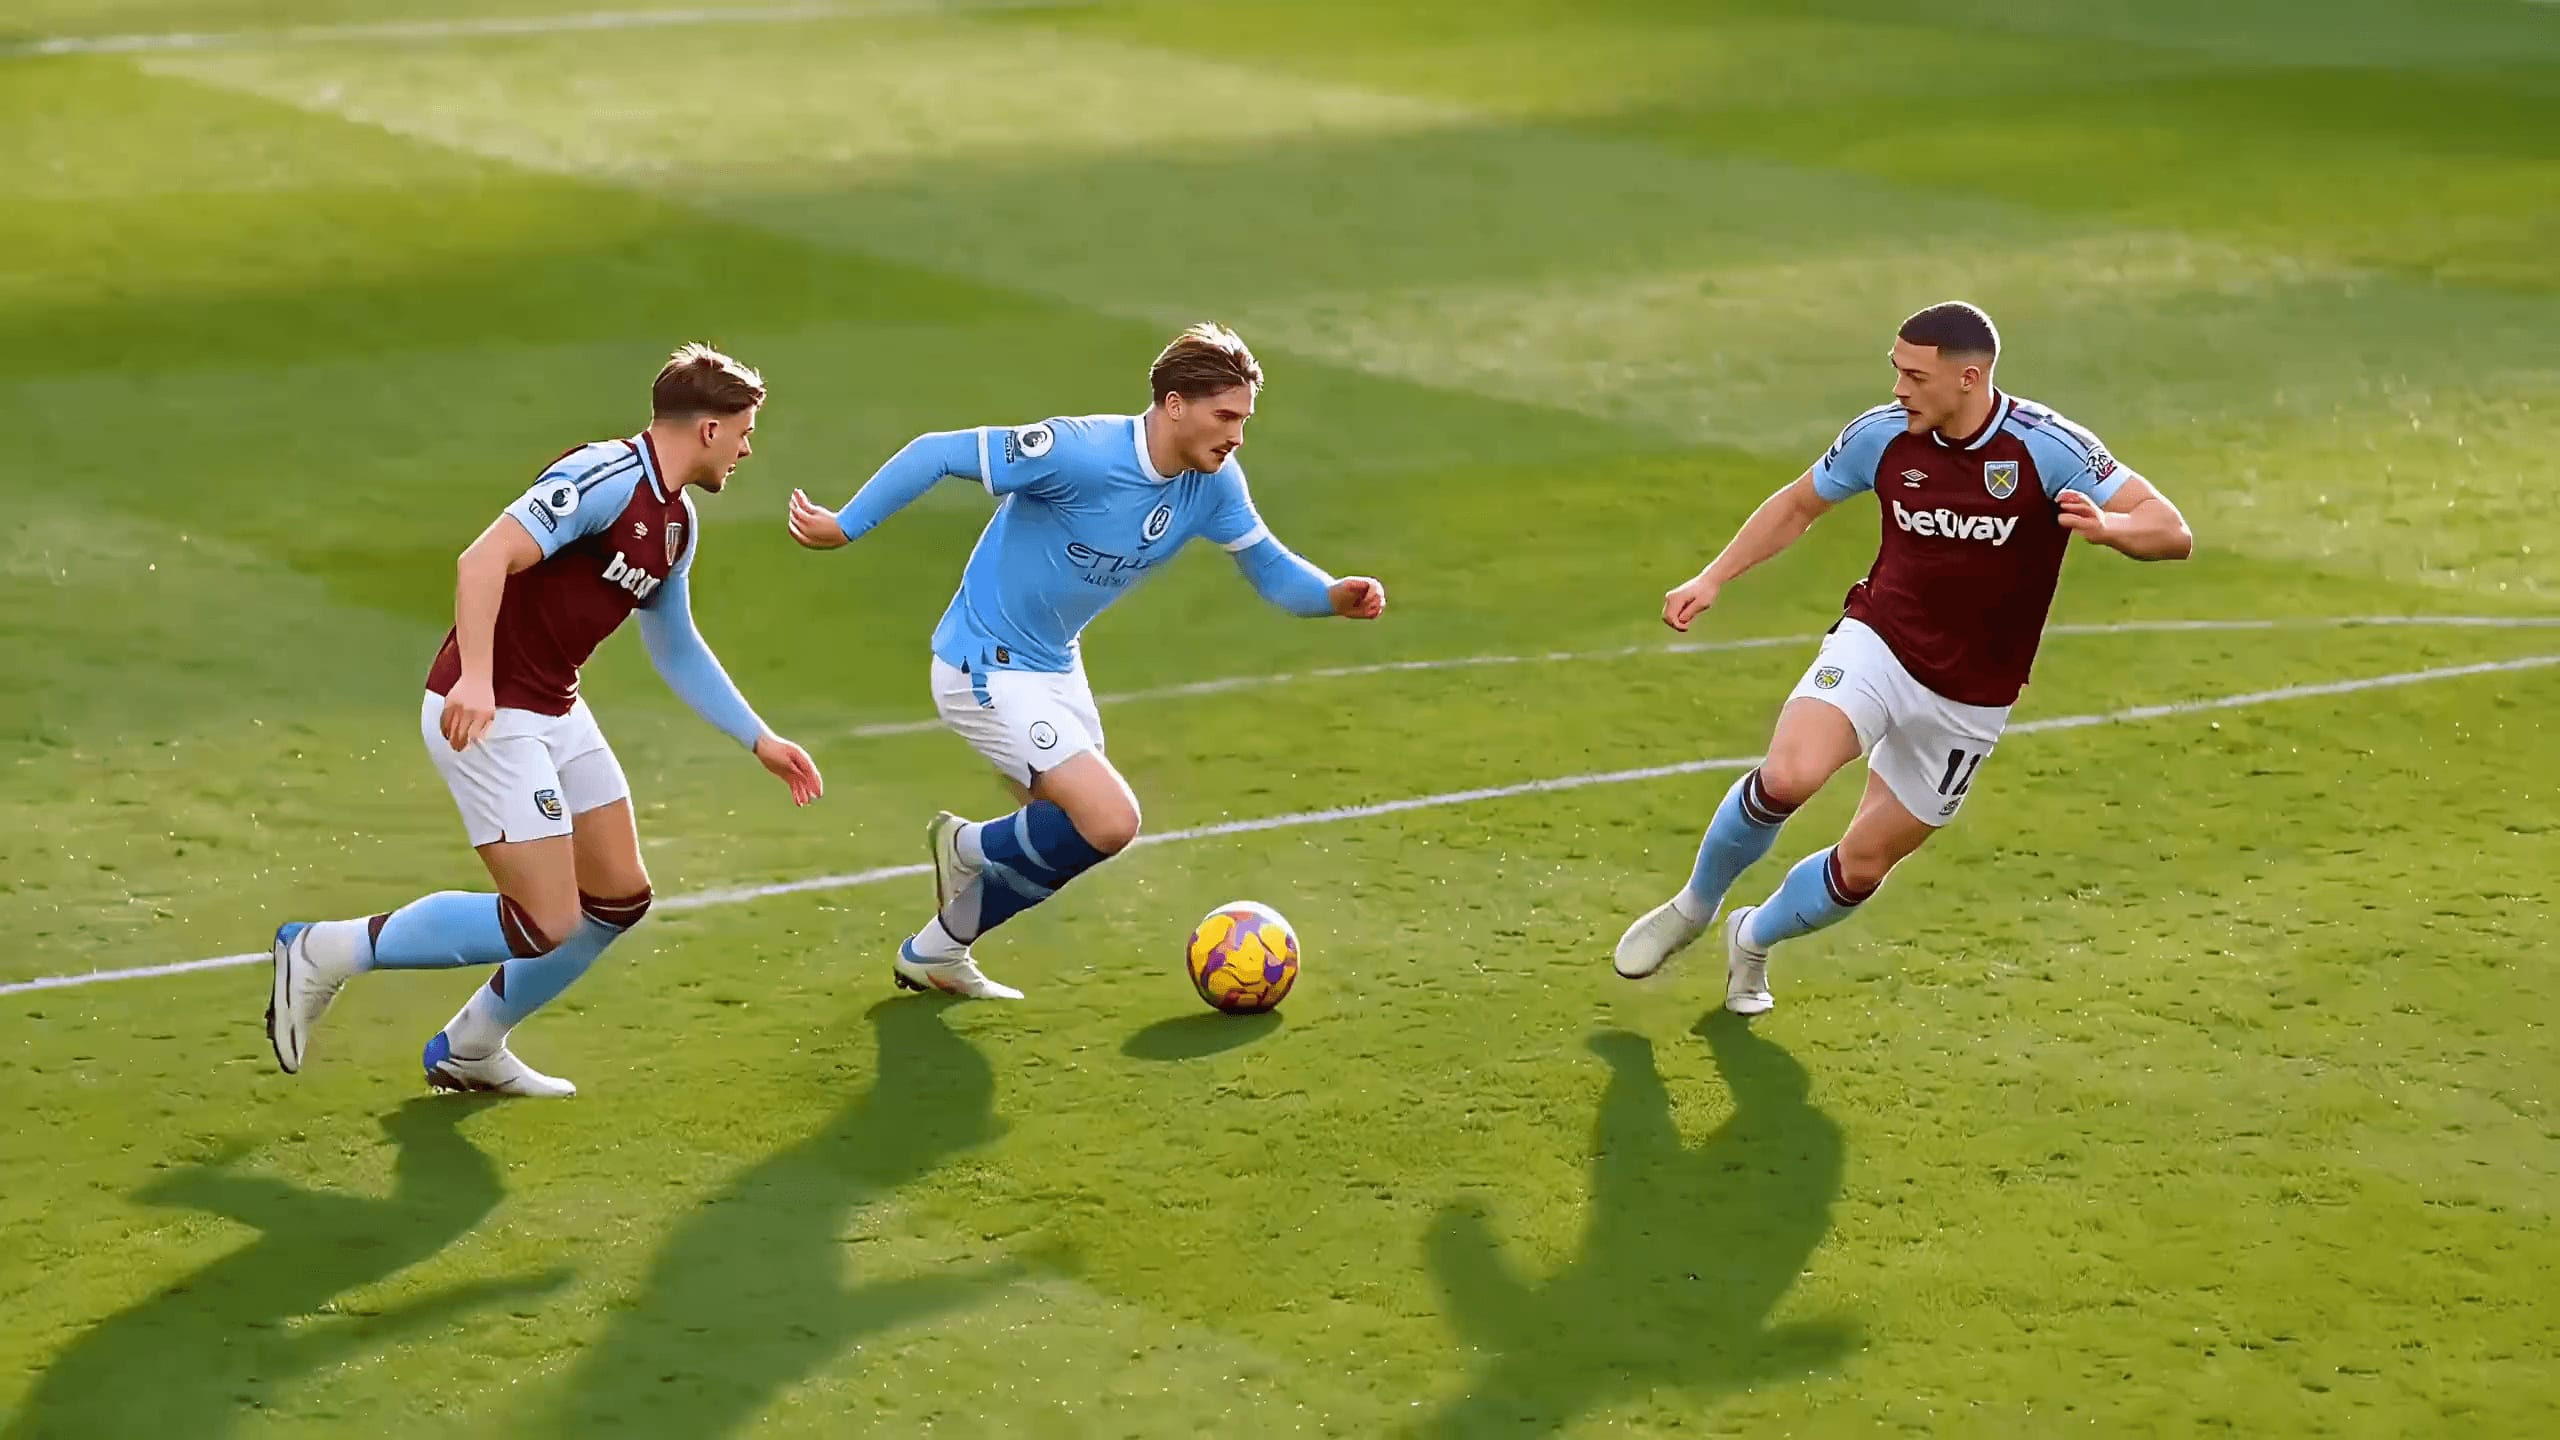
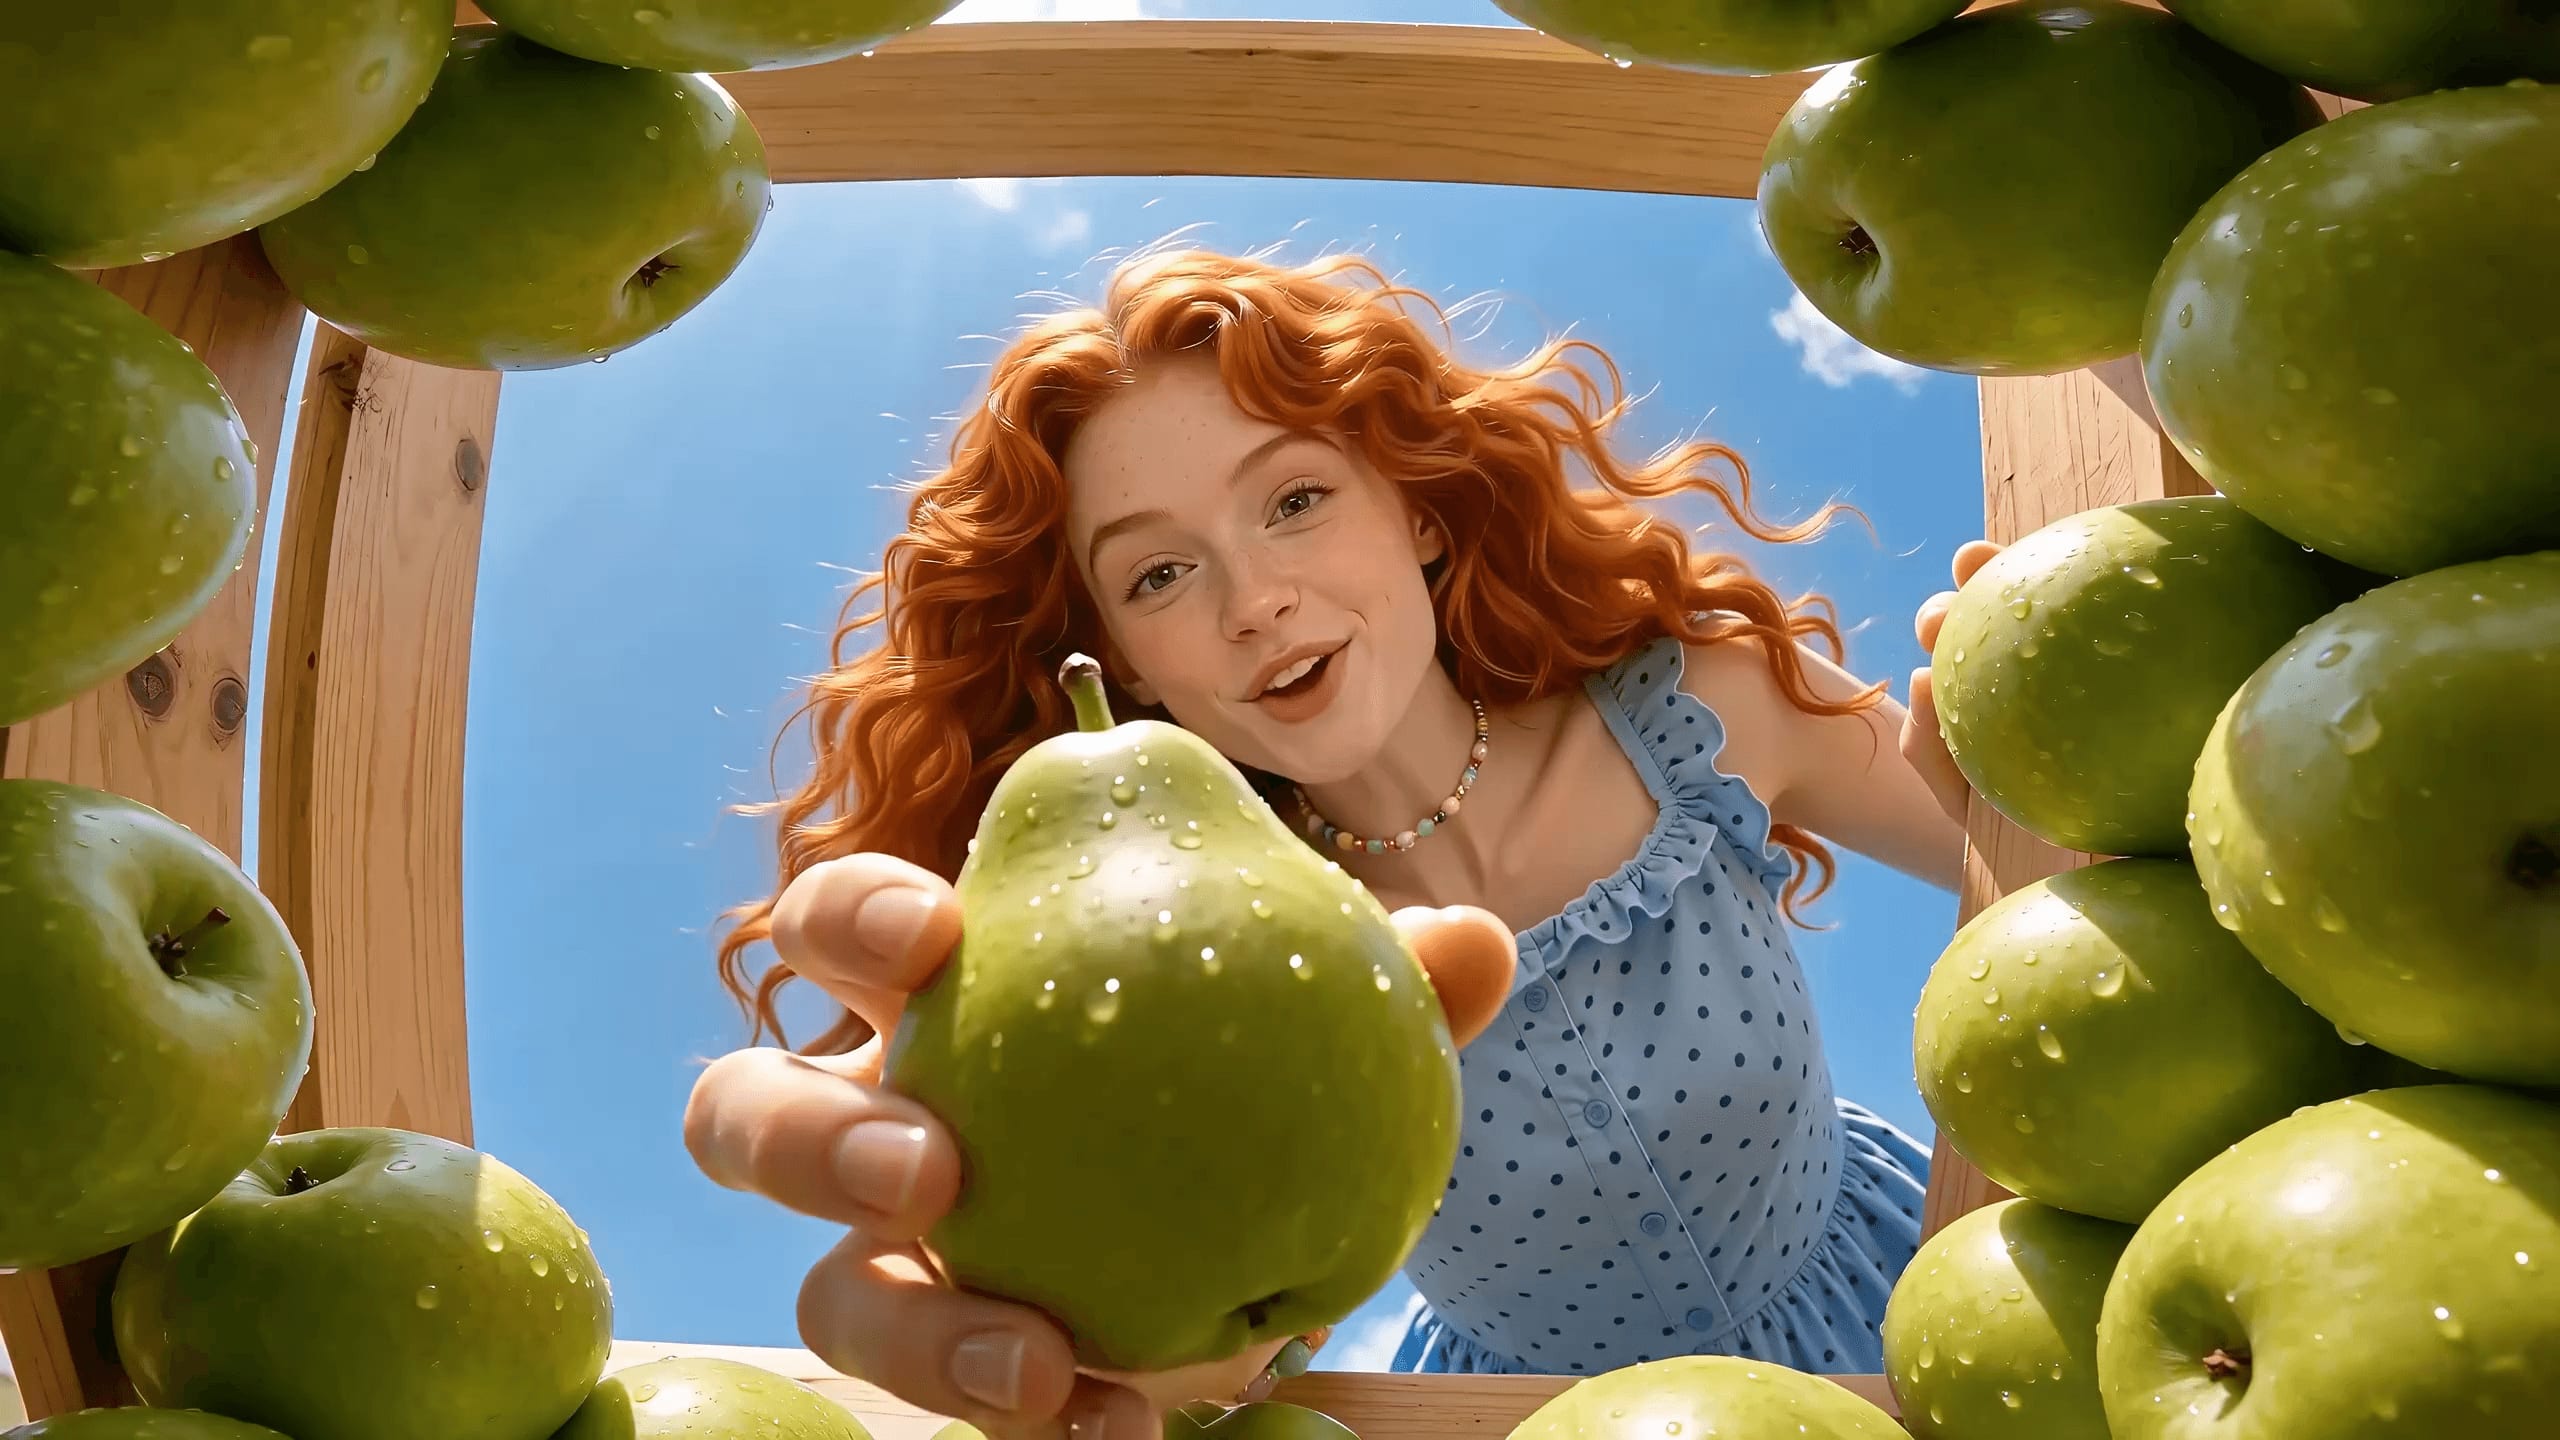
優しい女性ボイス英語
WAND で、EC の新商品投入を加速
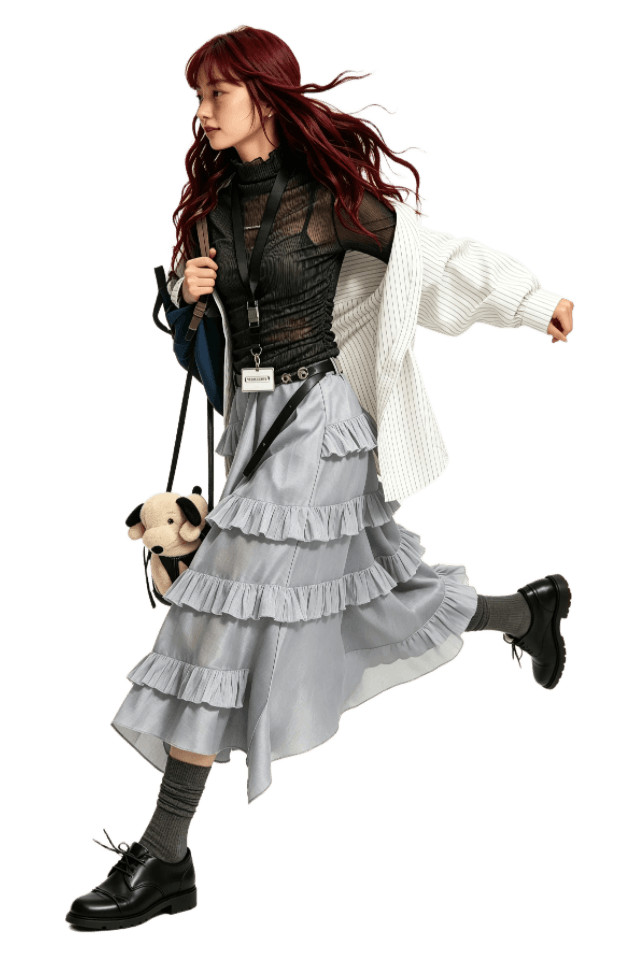
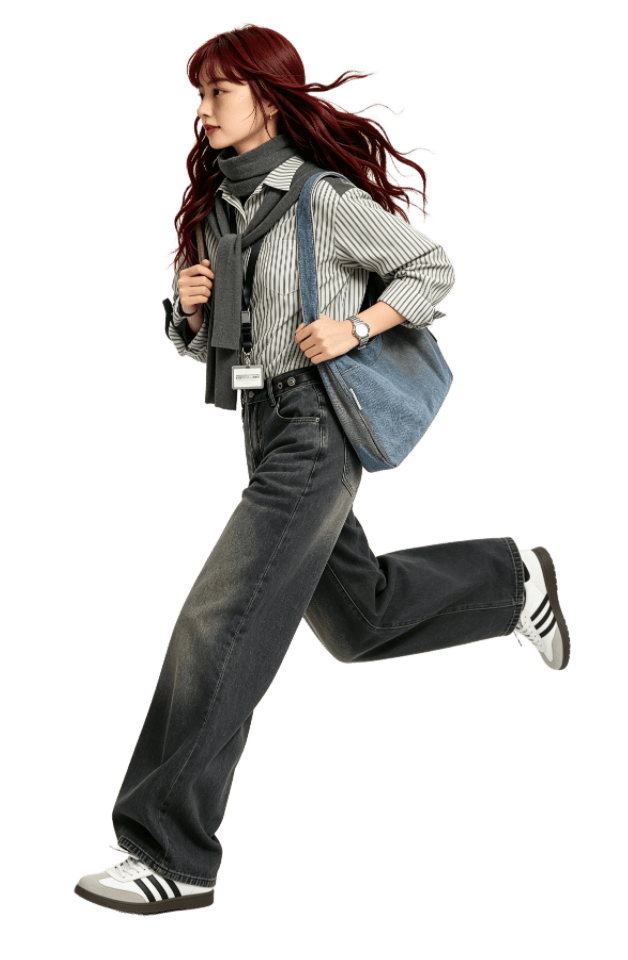
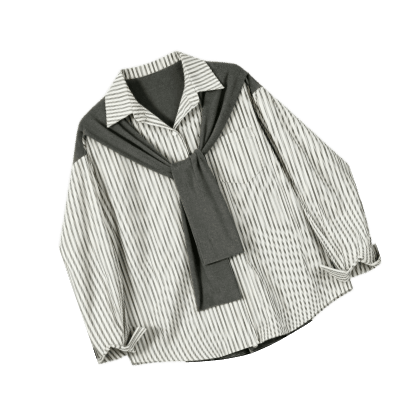
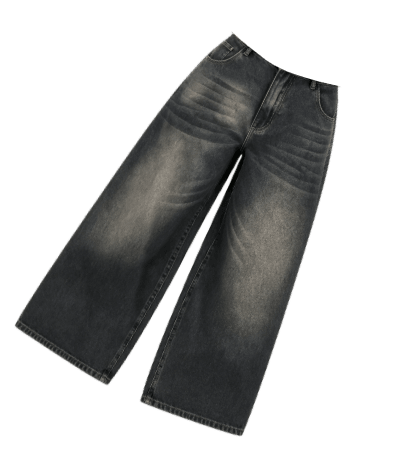
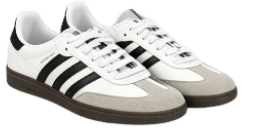
画像のモデルにこの服を着せて
AI 着せ替え
商品画像セット
画像補正と切り抜き
AIGC 商品動画
透かし・字幕の除去
電子透かしと追跡
動画をアニメ風に変換して、キャラクターの一貫性を保って
脚本と絵コンテを一式生成して
脚本生成と絵コンテ制作
AI 画風変換
キャラクター一貫性
AI 吹き替えと多言語化
字幕消去 / シームレス消去
画質向上と TSC エンコード
このライブ配信を横画面から縦画面に切り替えて、英語を中国語に変換して
AI 実況とスイッチング
ハイライト自動検出
AI リアルタイム縦横変換
リアルタイム 4K 超解像
多言語字幕と吹き替え
全工程の品質検査と追跡透かし
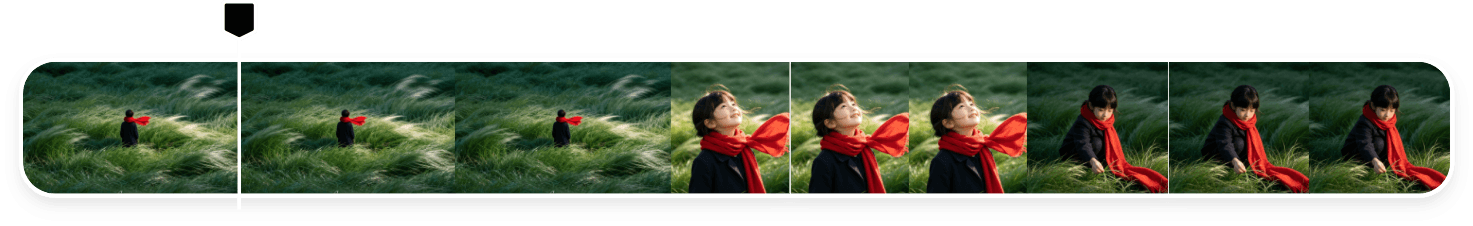
これらのカットをつなげて、用意した BGM を付けて~
マルチモーダル理解
スマートシーン分割
ハイライトと要約
字幕抽出と意味検索
重複排除と自動整理
縦横画面の自動変換
事前コンテンツ審査
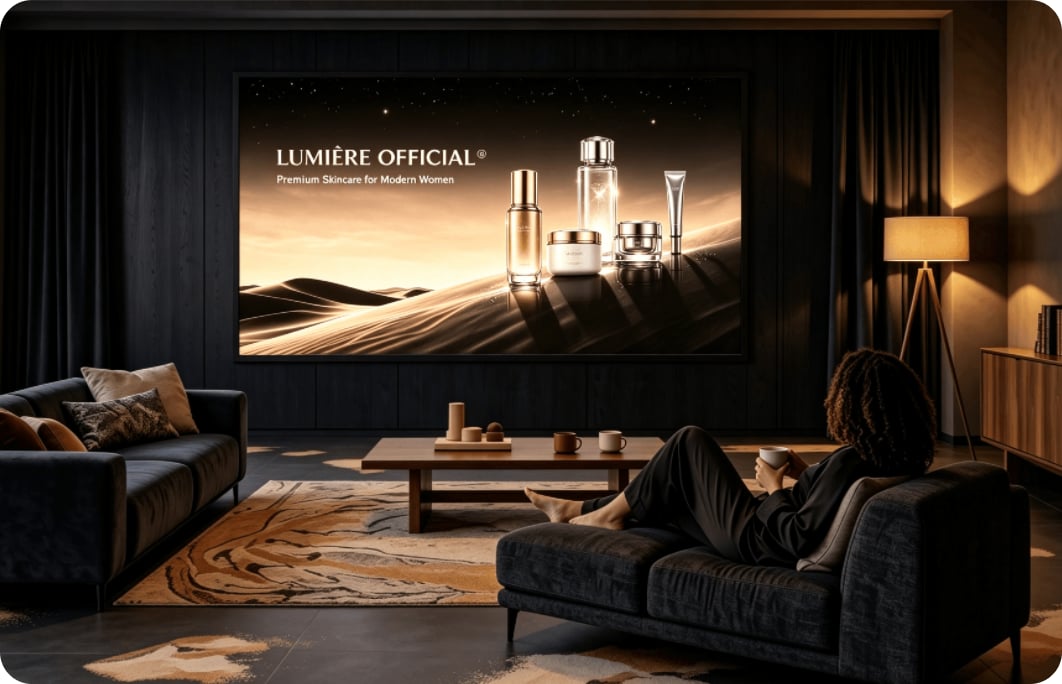
 独身女性向け広告
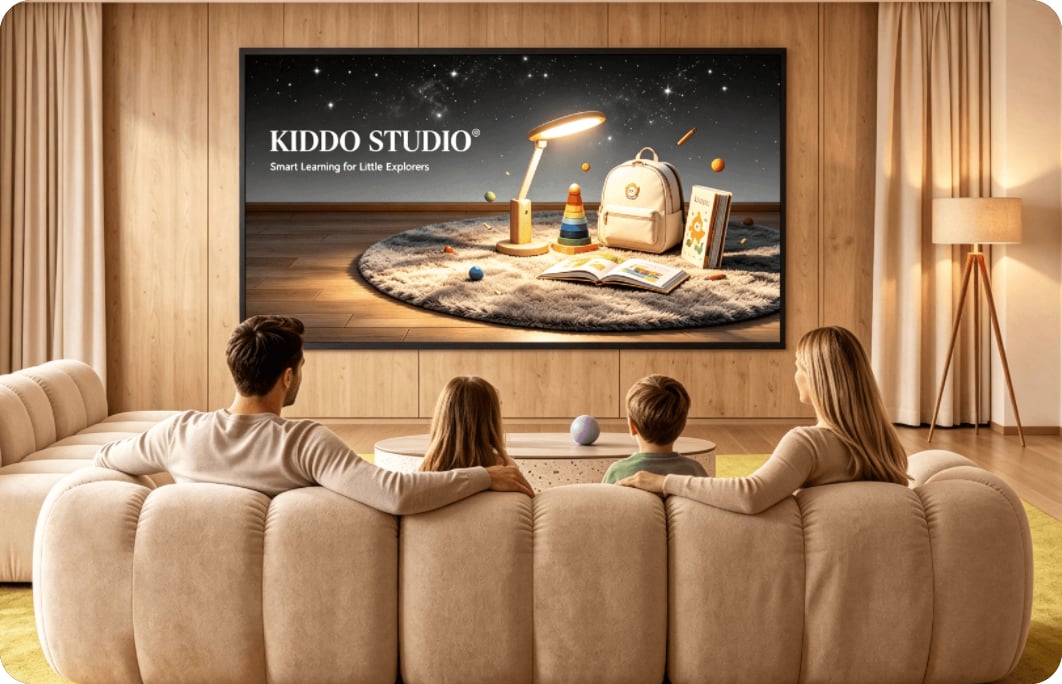 子育て世帯向け広告
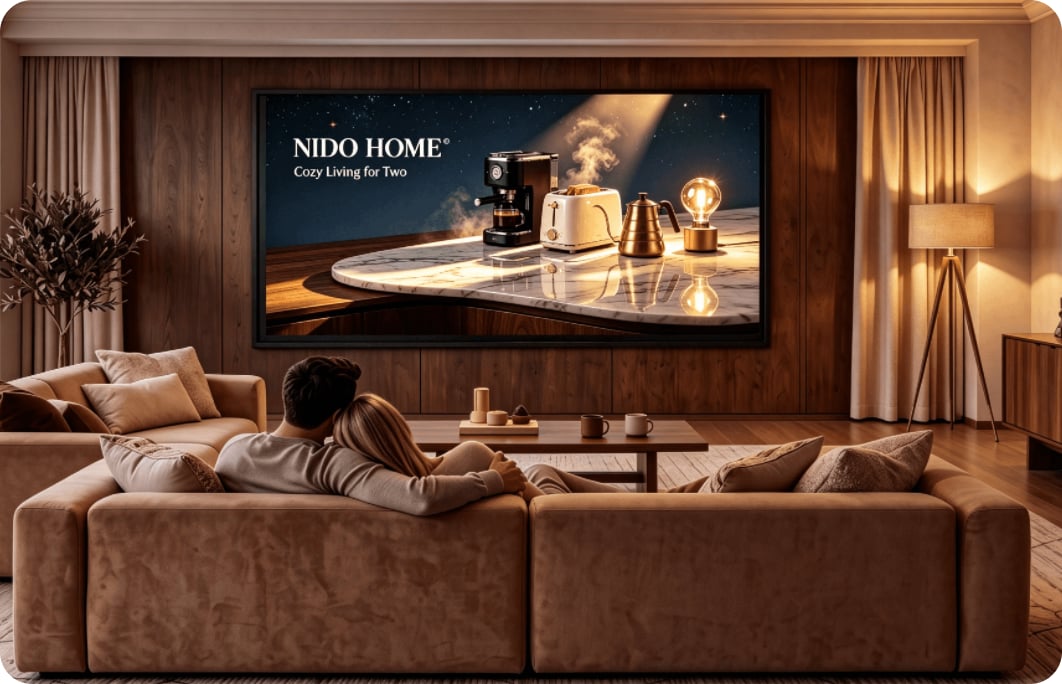 既婚カップル向け広告
スマート信号取り込みとプロトコル変換
スマート経路と冗長化
ライブストリームのリアルタイム理解
リアルタイム 4K 超解像
動的広告挿入(SSAI)
電子透かしと追跡
EC クリエイティブ Agent
業界トップクラスの実績と、優れた使いやすさ
800M+1日あたりの処理量(分)
90%+業界をリードする動画プラットフォームを支援
20+yrs技術とデータの蓄積
No.1IDC レポートで長年連続のシェア
Agent で利用する
API 連携は不要。ひと言の指示で Agent が WAND の全機能を自動でインストールし、呼び出します。
https://skillhub.cn/install/skillhub.md に従って @tencent-adm/tencent-mps-intl をインストールしてください。
その他の連携方法
1 行のコマンドでインストールが完了し、ローカルプロジェクトや CI パイプラインに素早く統合できます。
コマンドライン連携は近日公開予定
グローバルコンプライアンス認証
安心してビジネスを展開
 より良い世界をつくる
A one-stop media AI platform — from creation to delivery