


텐센트 미디어 AI 모델 WAND 전면 개방, 미디어 크리에이티브를 상상에서 결과물 전달까지 원스톱으로 실현합니다

WAND
Enhance+
EraseVibe+
Vega
Codec+
Vega VL
Vega Audio
화질 향상 모델
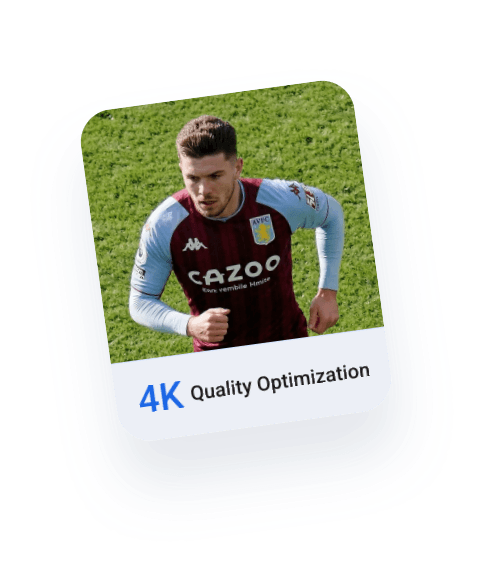
WAND-Enhance+는 DiT 대형 모델을 기반으로 한 화질 향상 모델입니다. 전역 컨텍스트 모델링으로 실제 텍스처 디테일을 재구성해 선명도와 투명감을 세대를 뛰어넘는 수준으로 끌어올립니다. 4K 초해상도, 지능형 프레임 보간(최대 120 FPS), 압축 열화 제거, SDR2HDR, 얼굴 향상 등의 기능을 지원합니다.
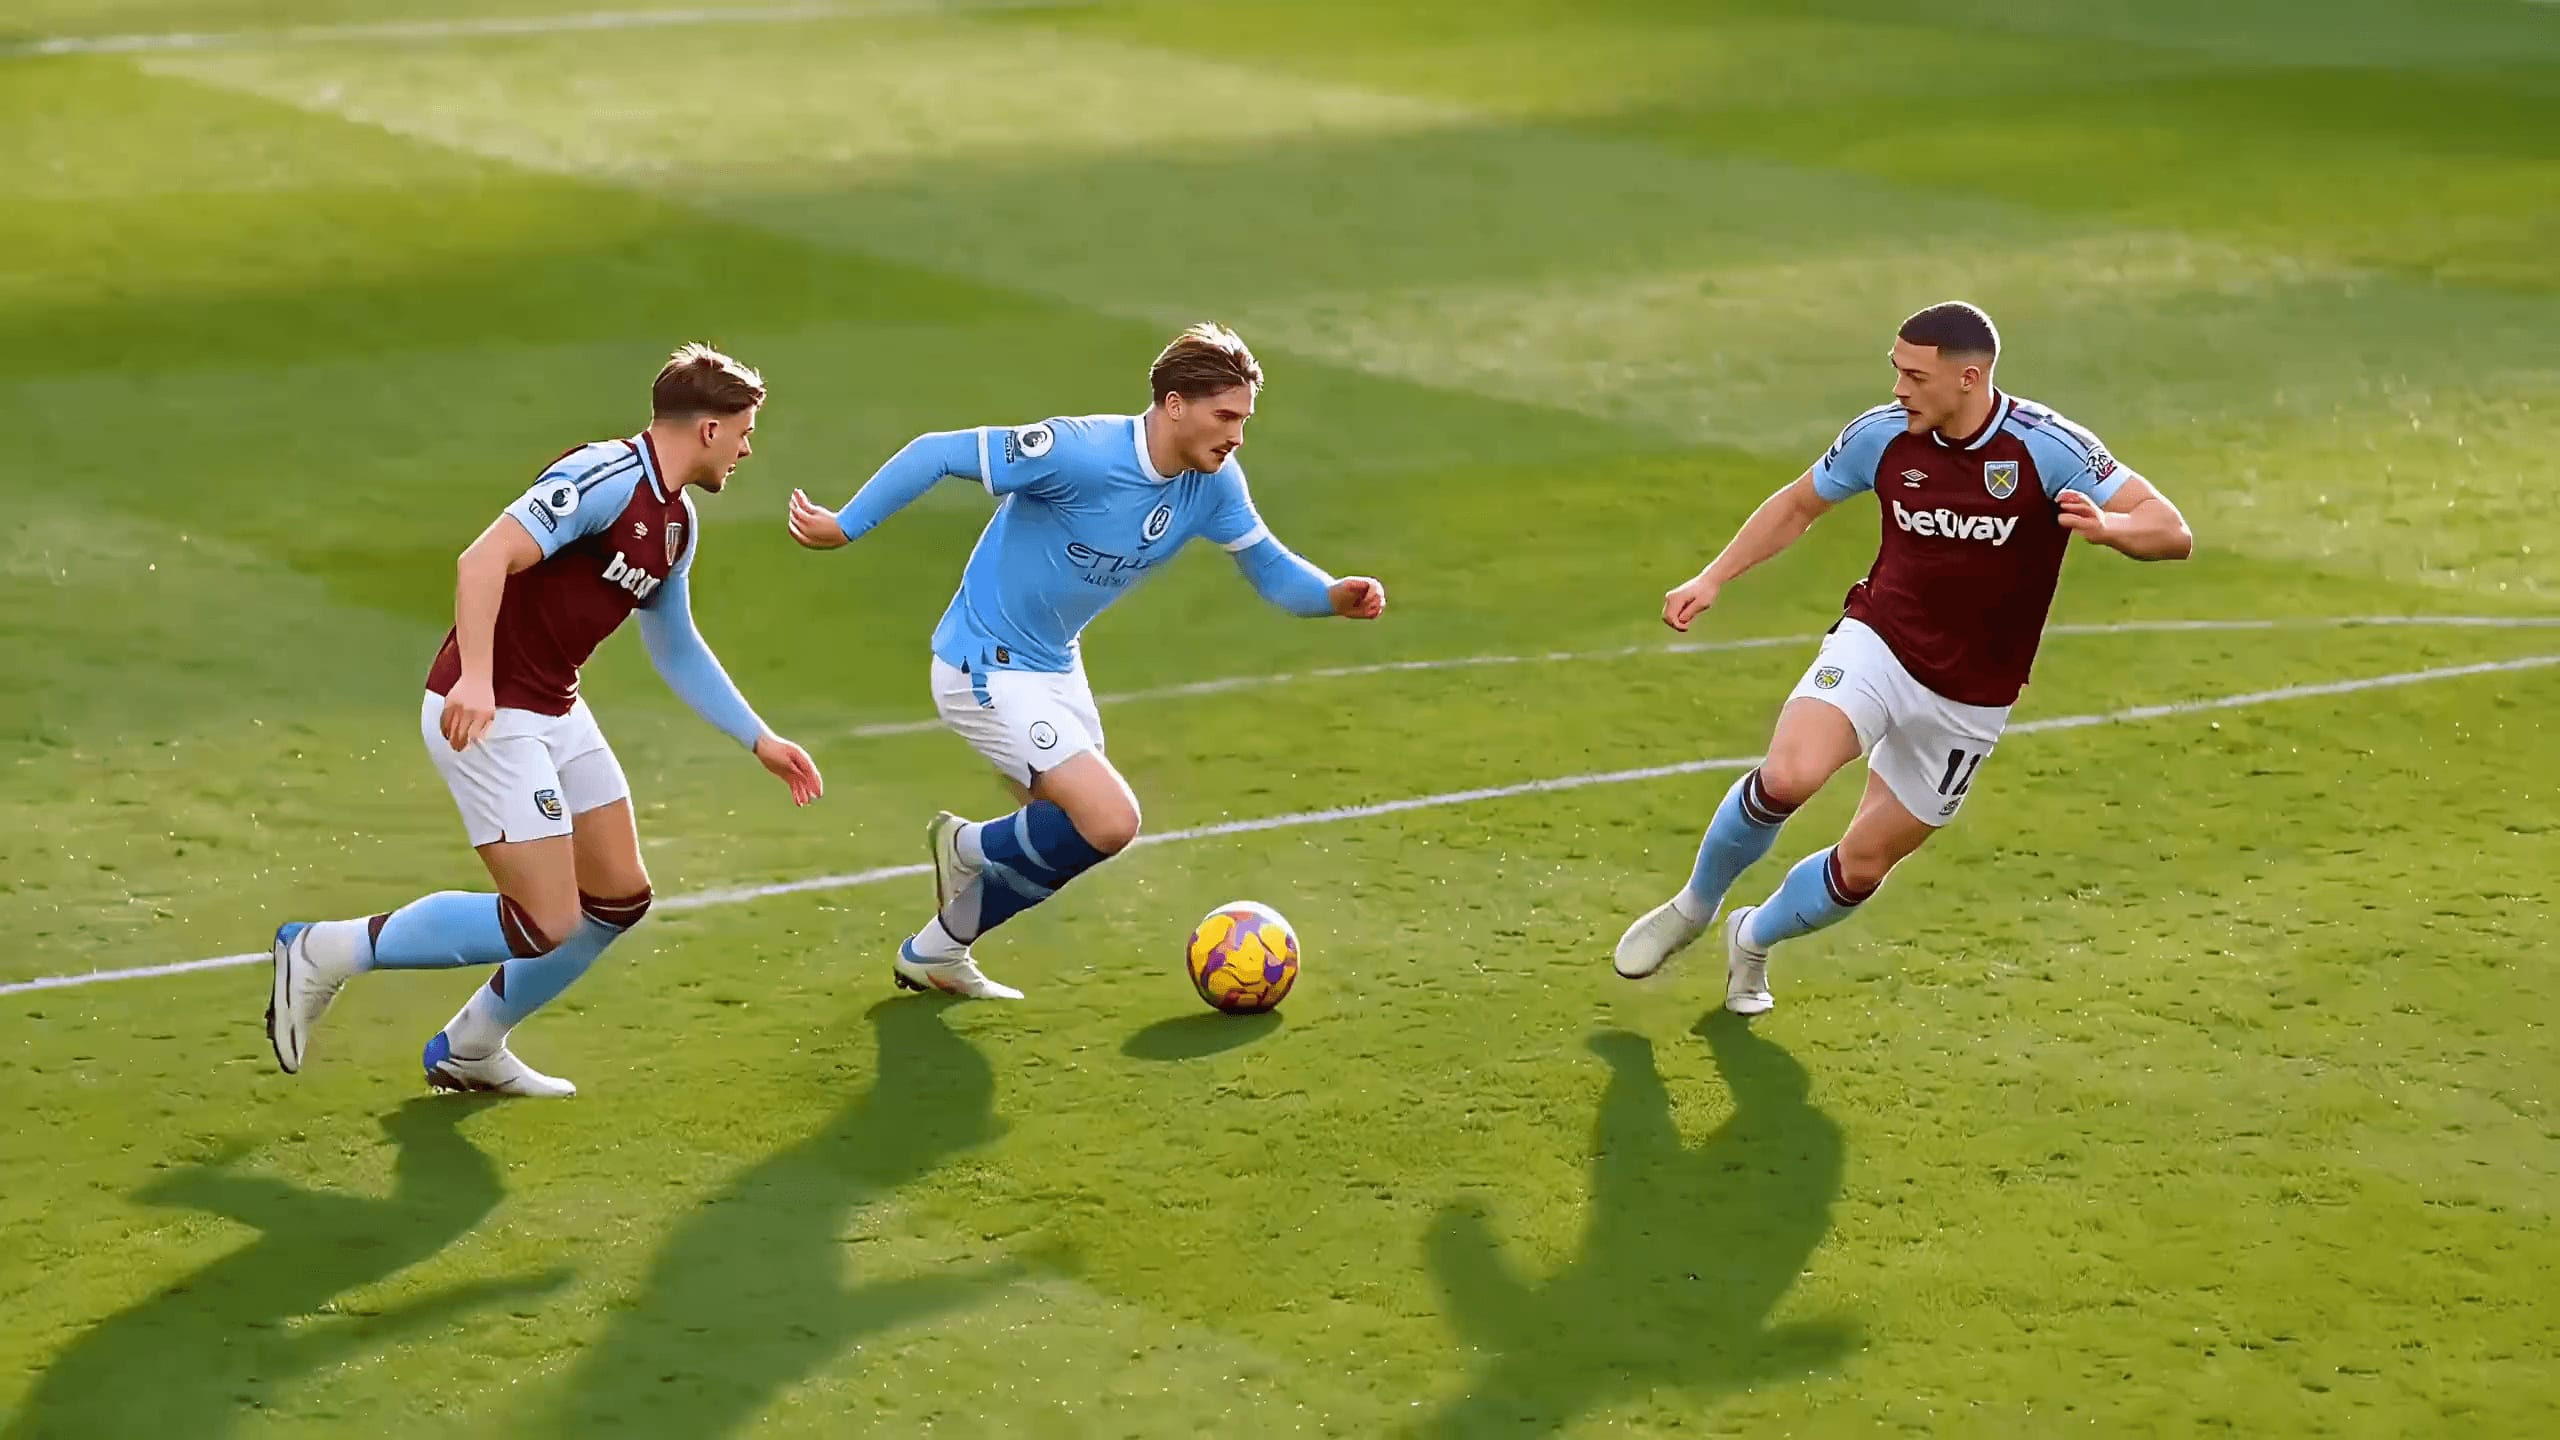
여인이 마당에서 천천히 눈을 뜨는 동시에 태극권을 시작하고, 일으킨 바람이 낙엽을 휘감아 올린다. 화면은 동일한 화풍을 유지
 WAND-Vega
영상 파라미터H.2644K
부드러운 여성영어
WAND로 신상품 출시를 앞당기세요
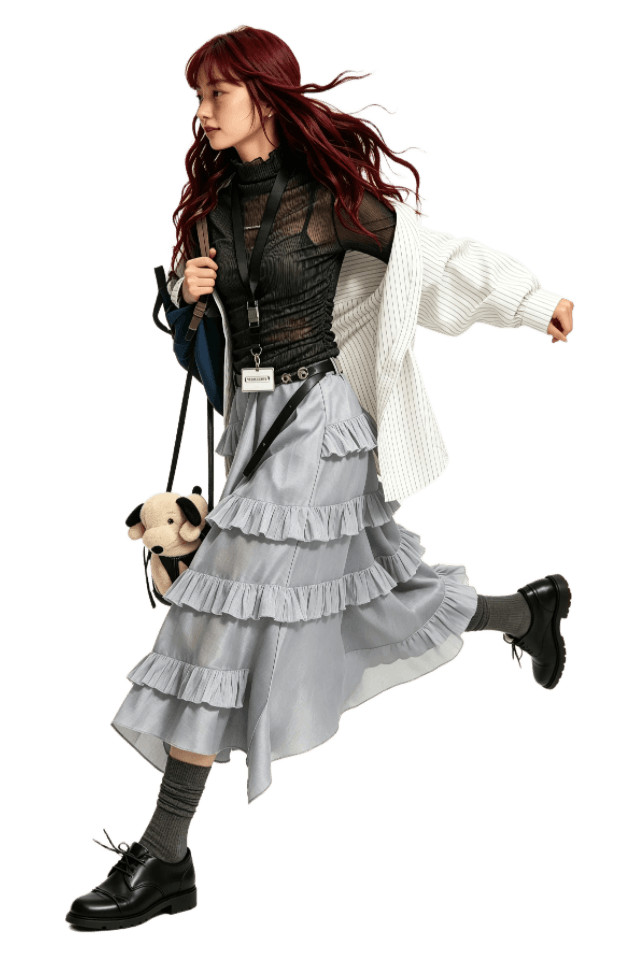
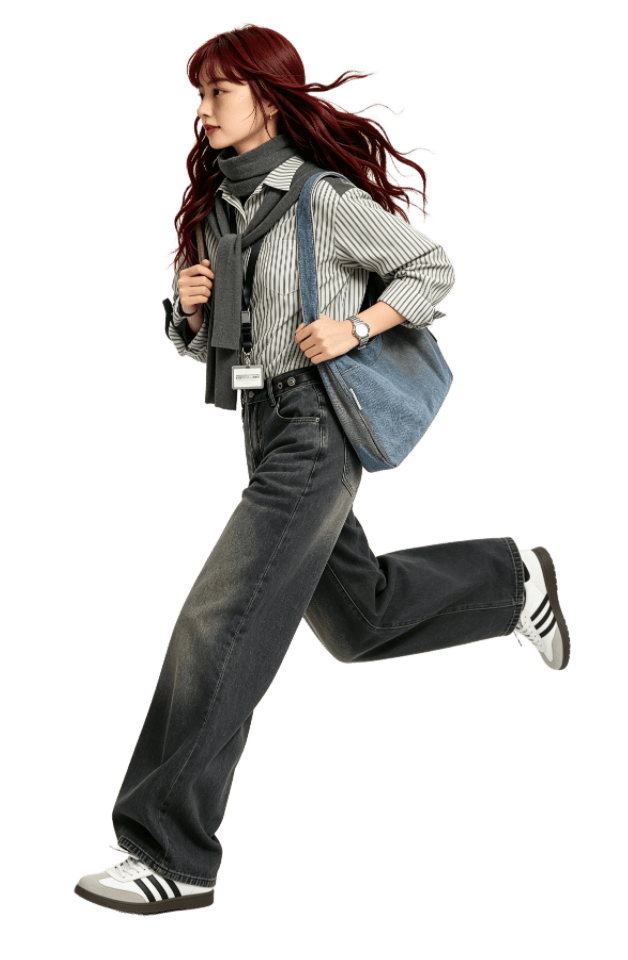
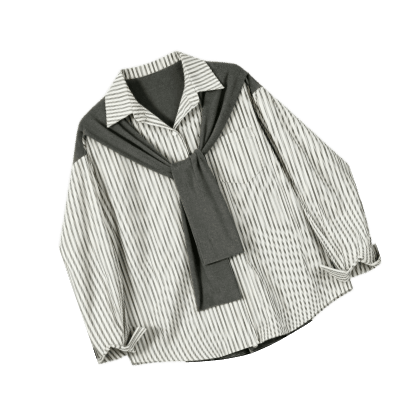
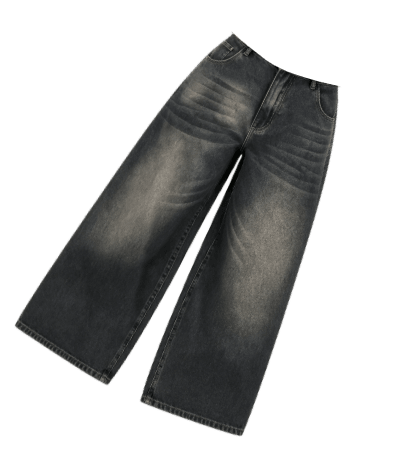
이미지 속 모델에게 이 옷을 입혀 줘
AI 가상 피팅
상품 이미지 세트
이미지 보정·컷아웃
AIGC 상품 영상
워터마크·자막 제거
디지털 워터마크·추적
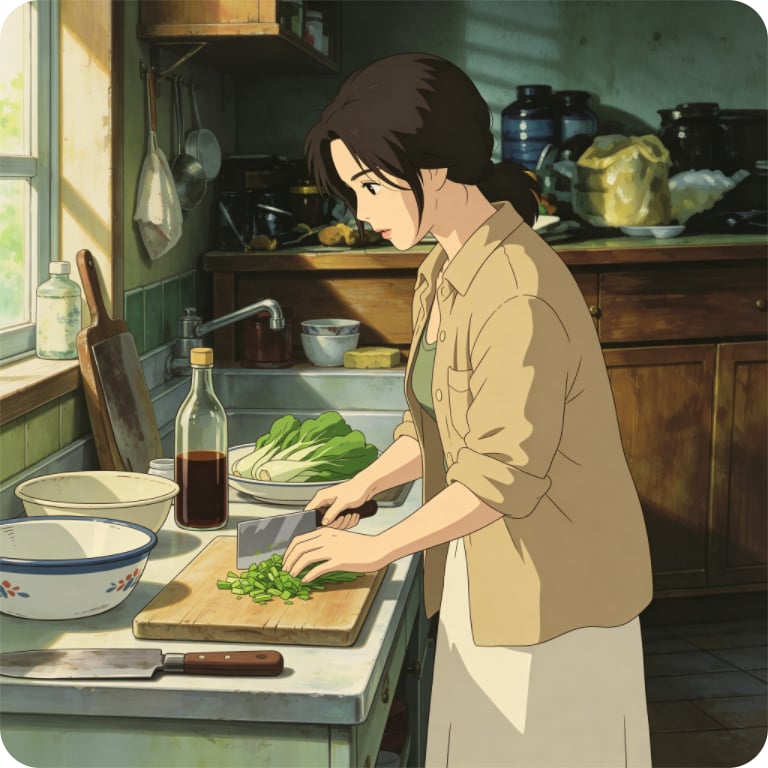
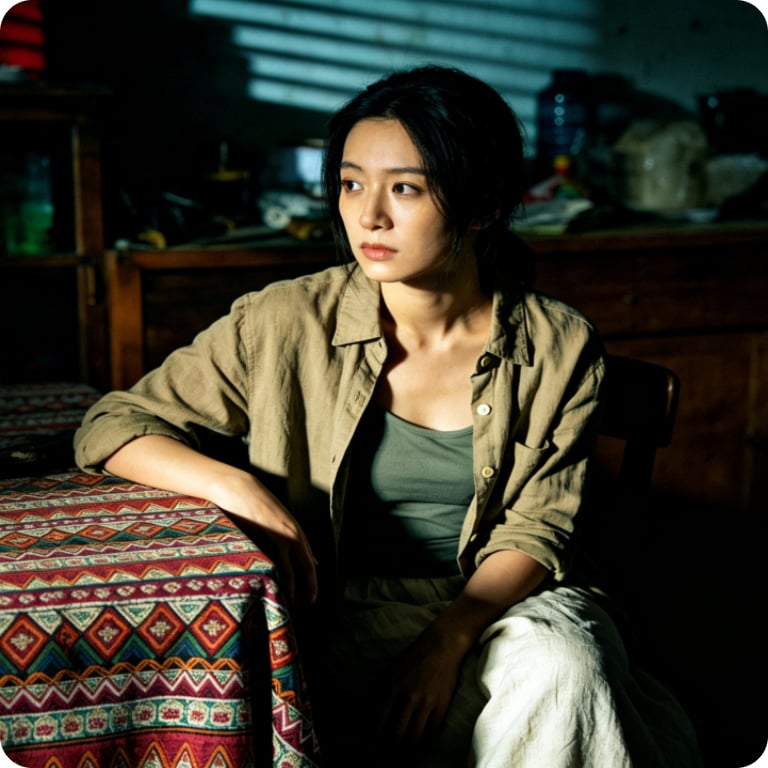
영상을 애니메이션 스타일로 바꾸고 인물 일관성을 유지해 줘
대본과 스토리보드를 한 세트 생성해 줘
대본 및 스토리보드 생성
AI 화풍 변환
캐릭터 일관성 유지
스마트 더빙 및 다국어 현지화
자막 제거 / 무흔적 제거
화질 향상 및 TSC 인코딩
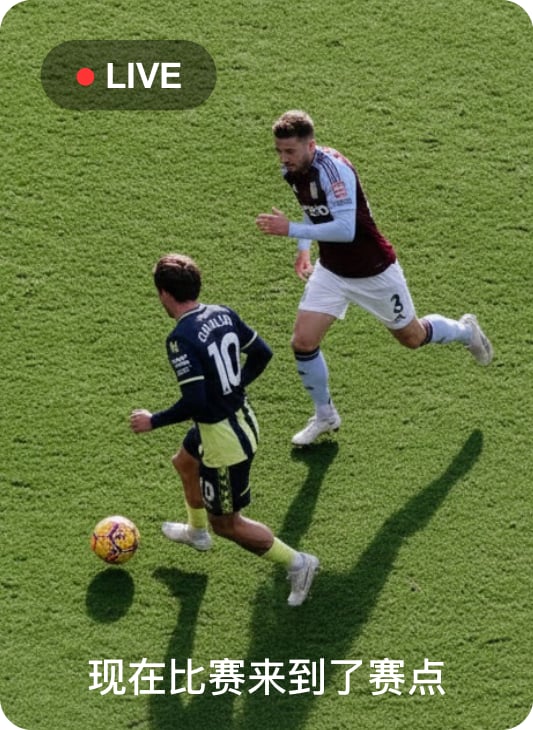
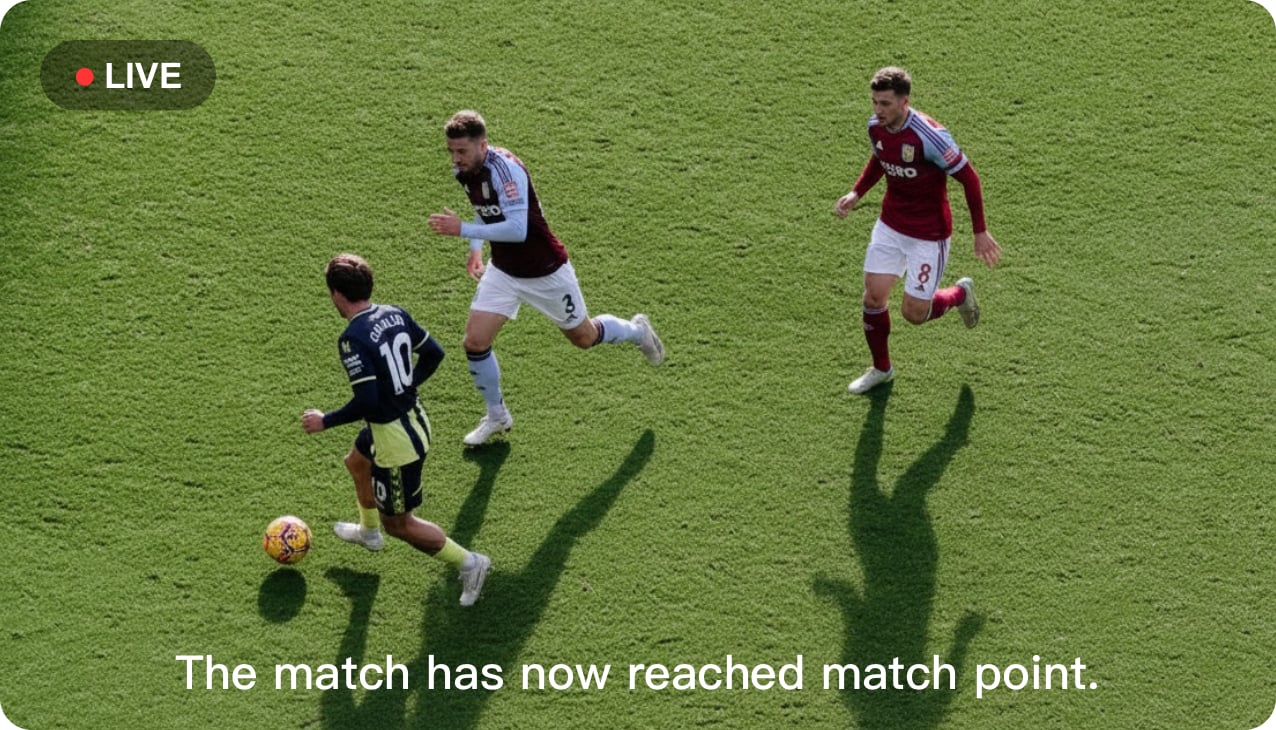
현재 라이브를 가로 화면에서 세로 화면으로 바꾸고 영어를 중국어로 변환해 줘
AI 해설 및 스마트 방송 제어
하이라이트 인식
AI 실시간 가로·세로 전환
실시간 4K 초해상도
다국어 자막 및 더빙
전 과정 품질 검사 및 추적 워터마크
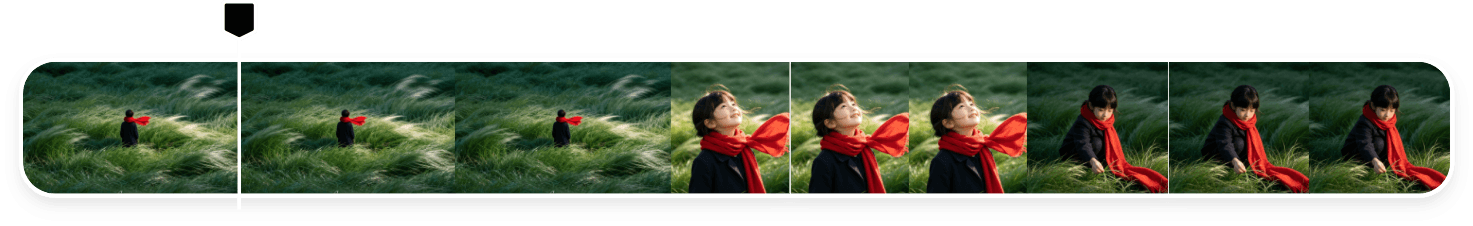
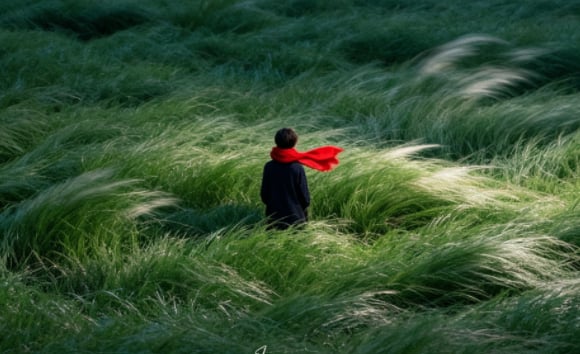
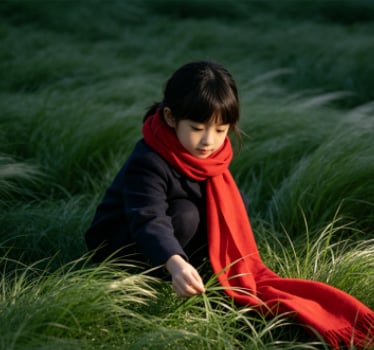
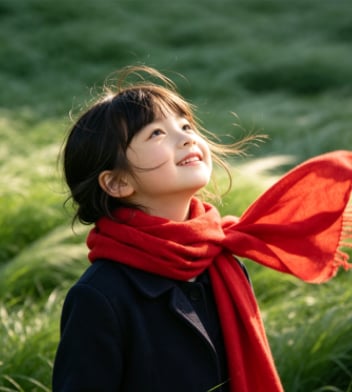
이 장면들을 하나로 편집하고 내가 준 BGM을 깔아 줘~
멀티모달 콘텐츠 이해
스마트 분할 및 장면 구분
하이라이트 및 요약
자막 추출 및 시맨틱 검색
중복 제거 및 자동 정리
가로·세로 자동 재구성
콘텐츠 사전 심사
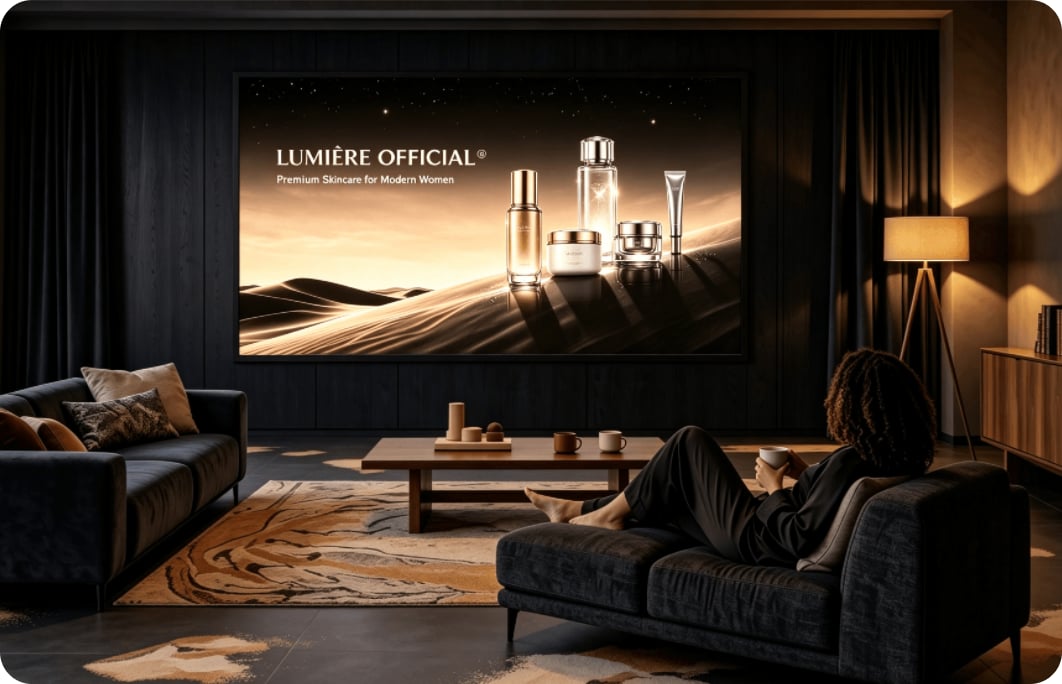
 싱글 여성 광고
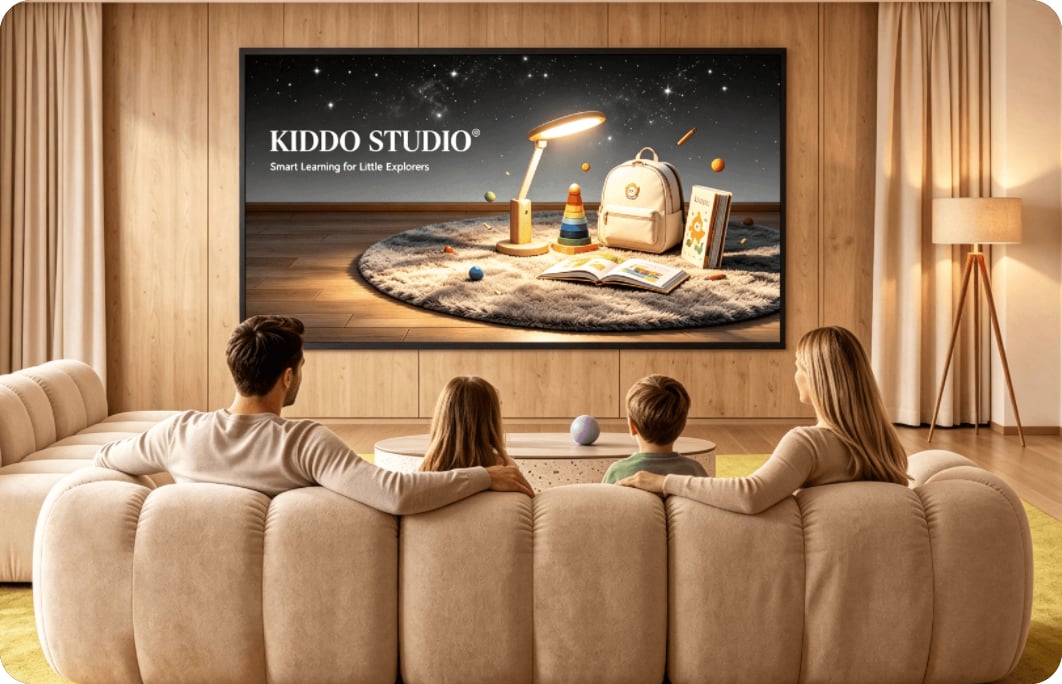 육아 가정 광고
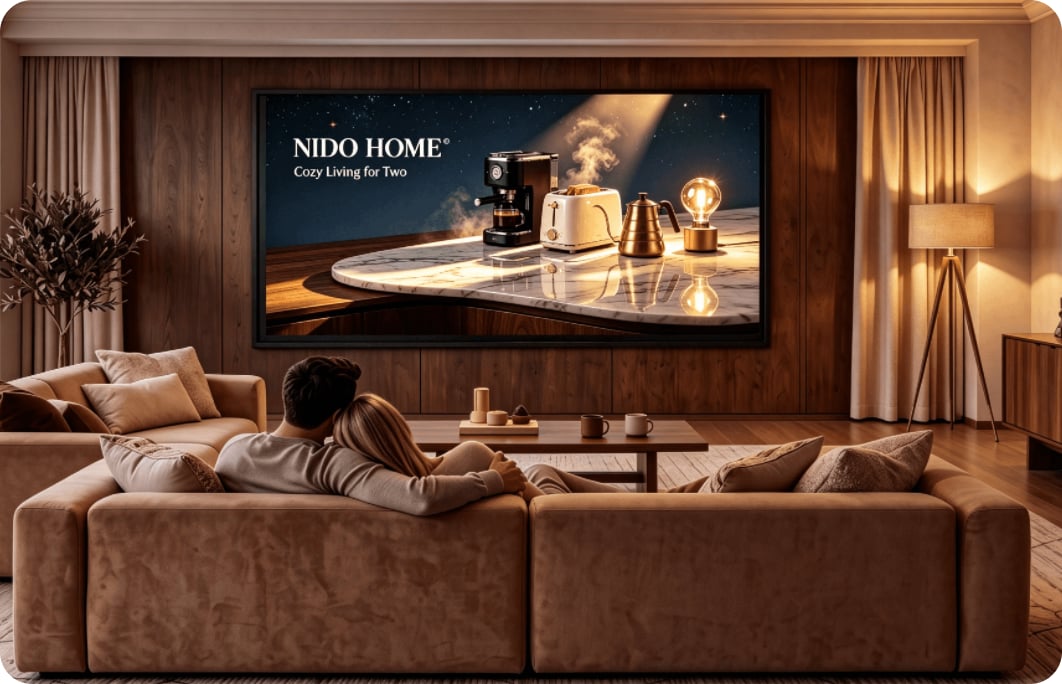 기혼 커플 광고
스마트 신호 수신 및 프로토콜 변환
스마트 라우팅·재해 복구
라이브 스트림 실시간 이해
실시간 4K 초해상도
서버 사이드 동적 광고 삽입(SSAI)
디지털 워터마크·추적
이커머스 크리에이티브 Agent
최고 수준의 데이터로 뒷받침되는 손쉬운 사용
800M+일일 처리 시간(분)
90%+선도적인 동영상 플랫폼 지원
20+yrs기술 및 데이터 축적
No.1IDC 보고서 기준 다년간 점유율
Agent에서 사용하기
API 연동 없이, 한마디 지시만으로 Agent가 WAND의 모든 기능을 자동으로 설치하고 호출합니다.
https://skillhub.cn/install/skillhub.md 를 참고하여 @tencent-adm/tencent-mps-intl 을 설치해 주세요.
추가 연동 방식
한 줄의 명령으로 설치를 완료하고 로컬 프로젝트와 CI 파이프라인에 빠르게 통합할 수 있습니다.
커맨드라인 연동 방식 준비 중
글로벌 컴플라이언스 인증
안심하고 비즈니스를 운영하세요
 더 나은 세상을 만들다
A one-stop media AI platform — from creation to delivery