


腾讯媒体 AI 模型 WAND 全面开放,让媒体创意,从想象到交付,一站完成

WAND
Enhance+
EraseVibe+
Vega
Codec+
Vega VL
Vega Audio
画质增强模型
WAND-Enhance+ 是基于 DiT 大模型的画质增强模型——以全局上下文建模重建真实纹理细节,清晰度与通透感跨代提升。覆盖 4K 超分、智能插帧(最高 120 FPS)、去压缩伪影、SDR2HDR、人脸增强等能力。
女子在院中慢慢张开眼睛的同时开始打太极拳,扬起的拳风把落叶卷起,画面保持相同画风
 WAND-Vega
视频参数H.2644K
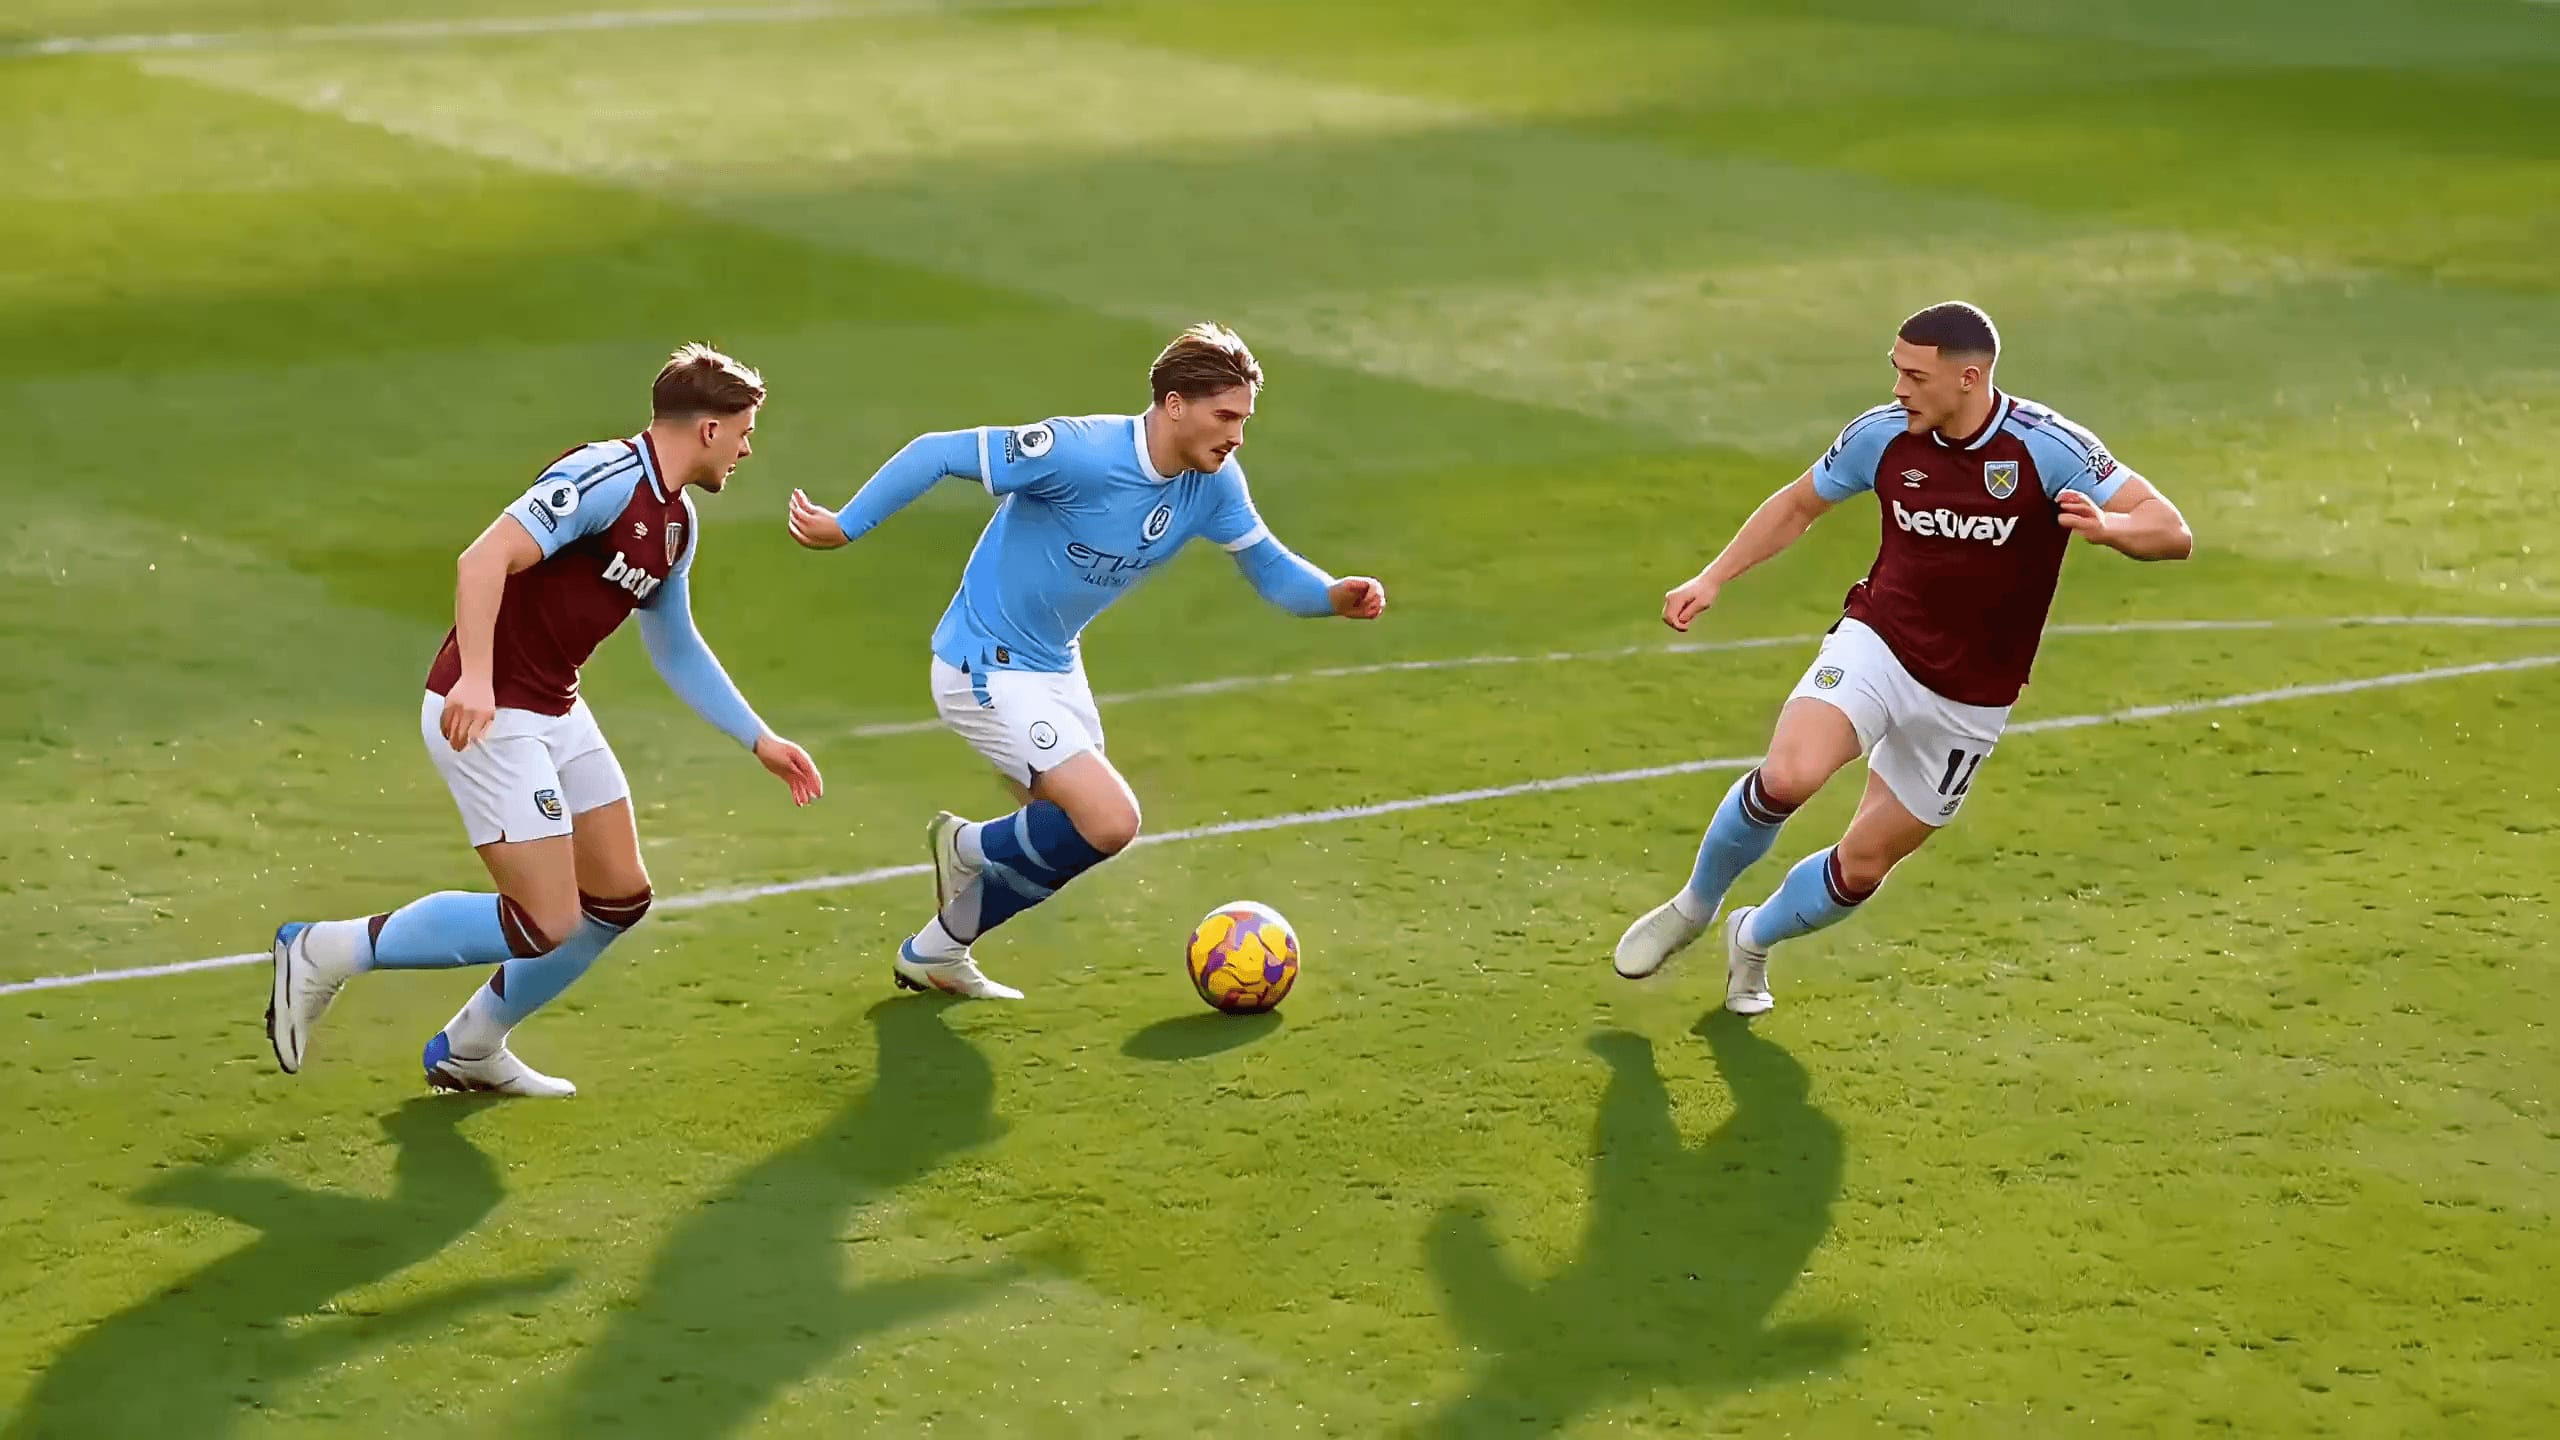
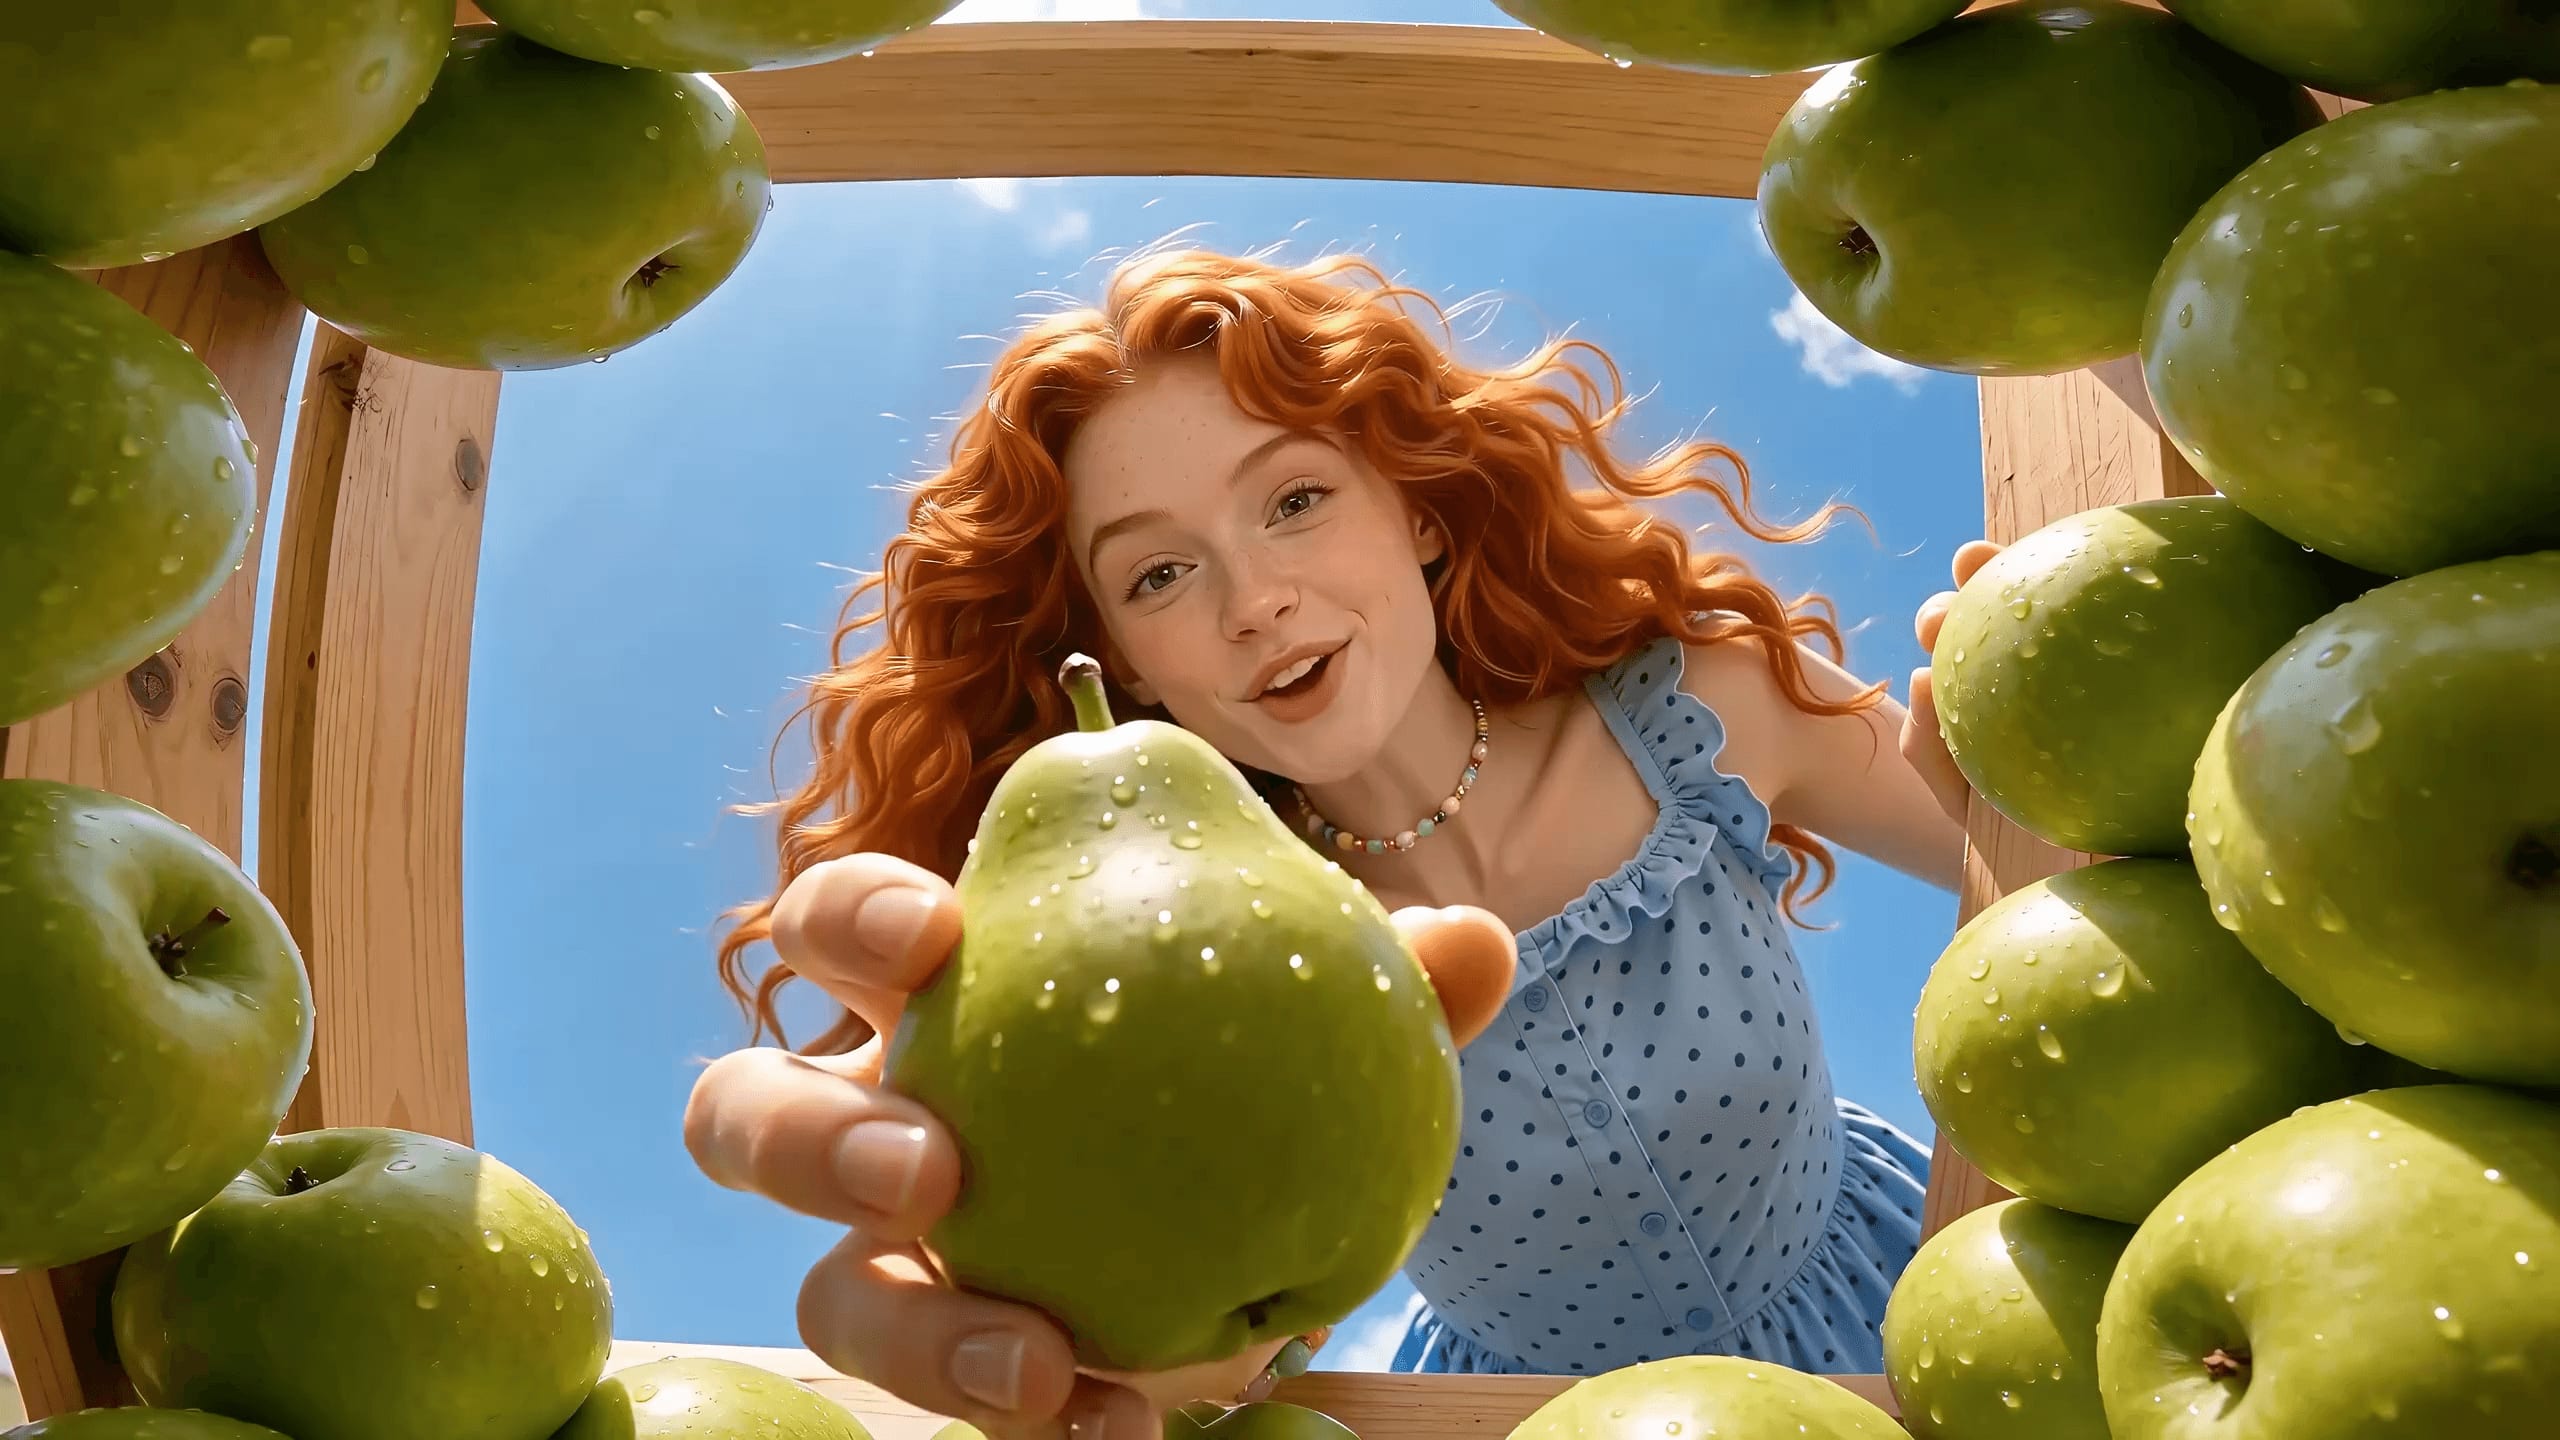
温柔女声英文
用 WAND,加速电商上新
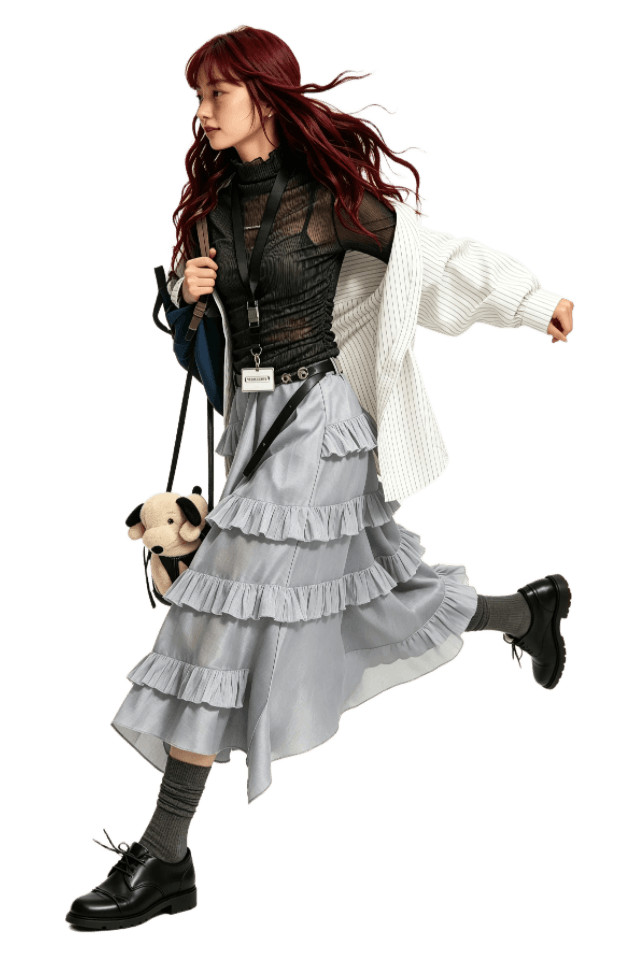
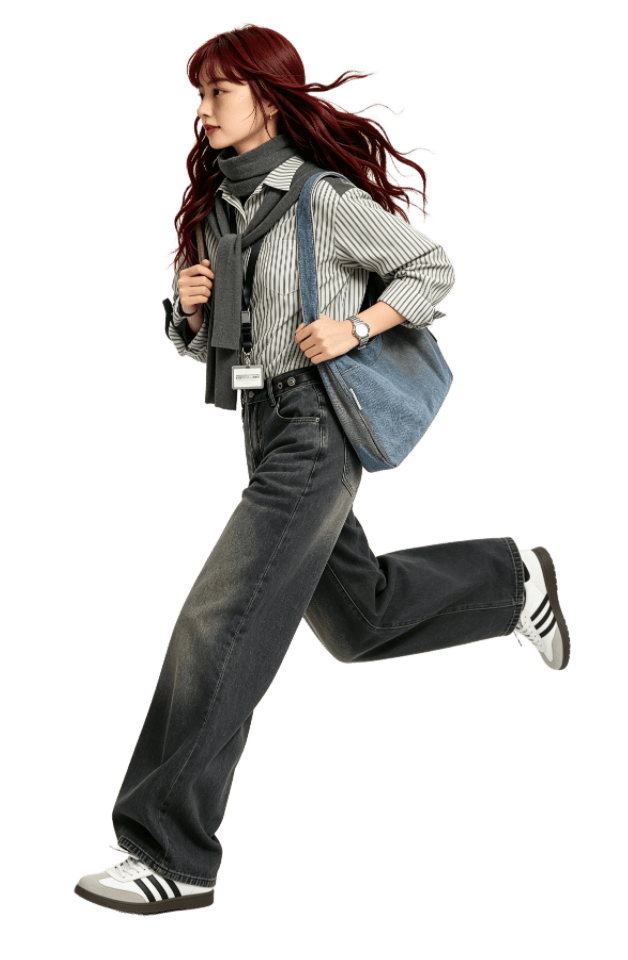
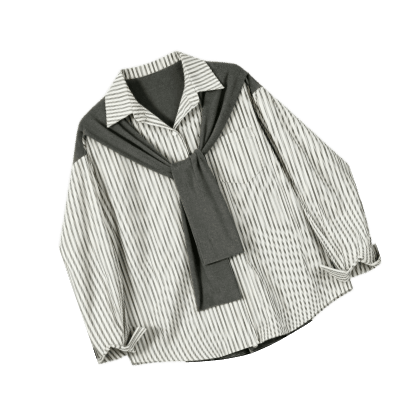
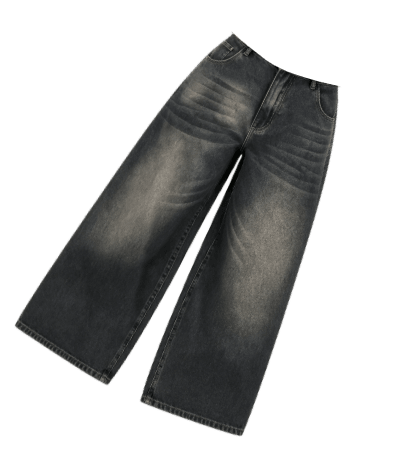
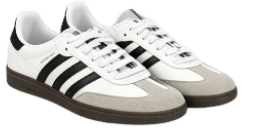
让图中的模特穿上这些衣服
AI 虚拟换装
商品套图生成
商品图增强与抠图
AIGC 商品视频
智能去水印 / 去字幕
数字水印与内容溯源
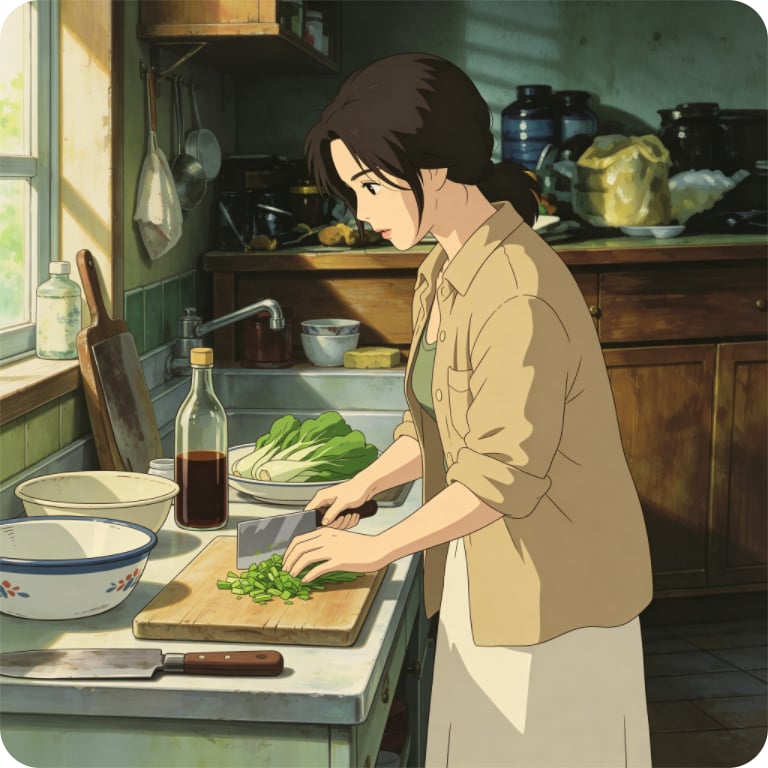
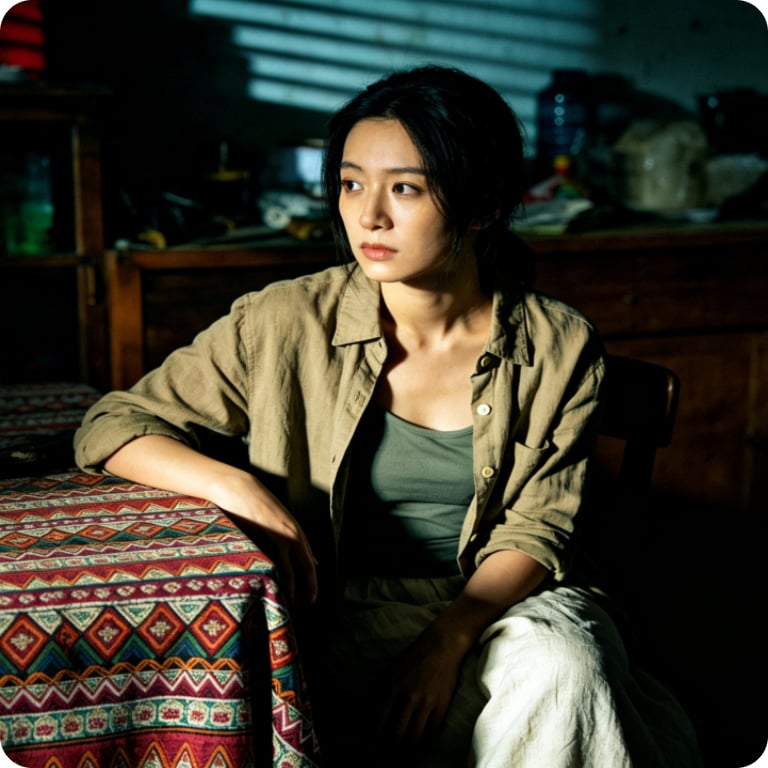
把视频转换为二次元风格,保持人物一致性
生成一套剧本生成与分镜制作
剧本生成与分镜制作
AI 视频转绘
角色一致性保持
智能配音与多语种译制
字幕擦除 / 无痕擦除
画质增强与极速高清编码
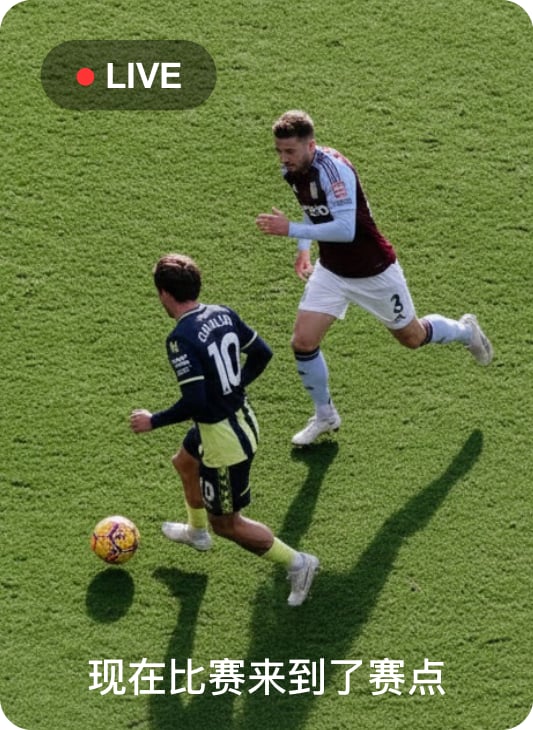
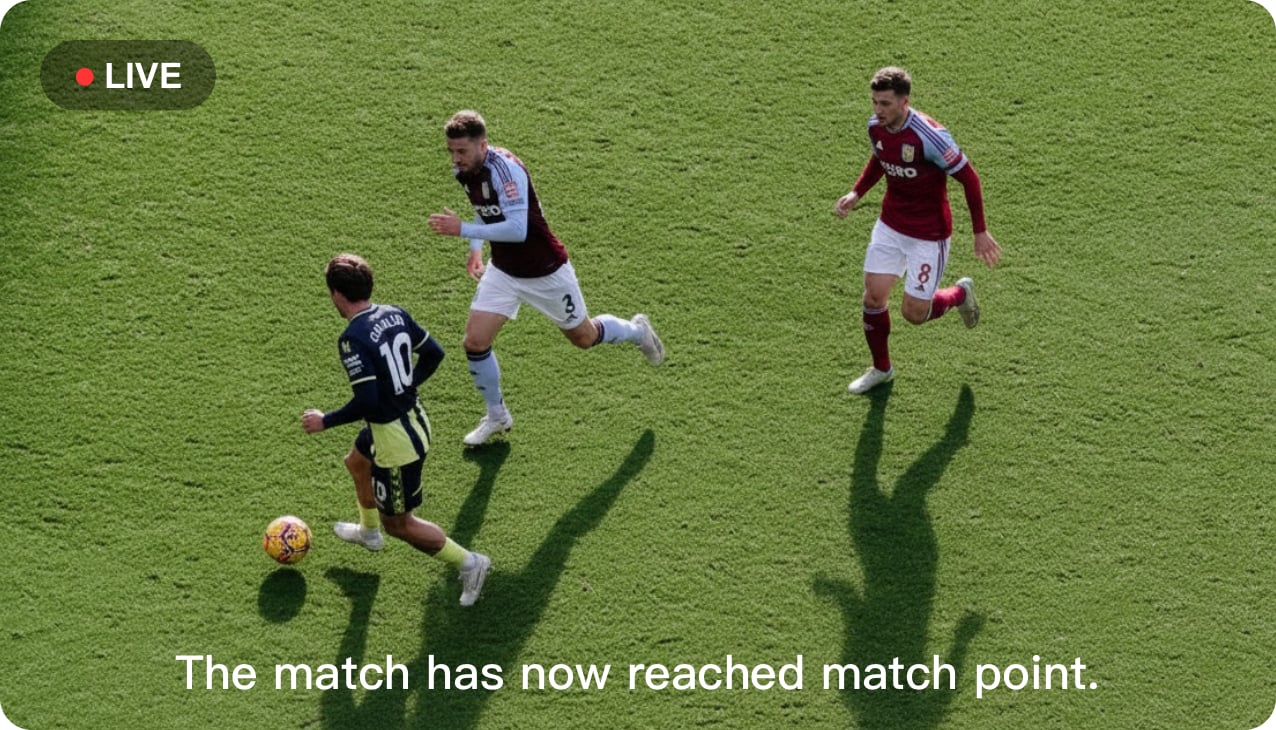
把当前直播从横屏换成竖屏,并且把英文转换为中文
AI 实时解说与智能导播
实时高光识别
AI 实时横转竖 / 竖转横
实时 4K 超分与画质增强
多语种字幕与配音译制
全链路质检与溯源水印
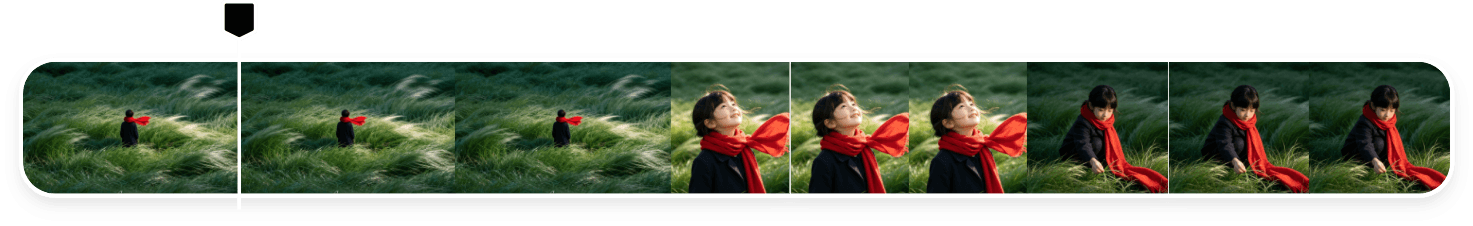
把这些镜头剪辑在一起,并配上我提供的BGM~
多模态内容理解
智能拆条与场景切分
精彩集锦与视频摘要
字幕提取与语义检索
AI 去重与自动归档
横竖屏自适应重构
内容审核前置
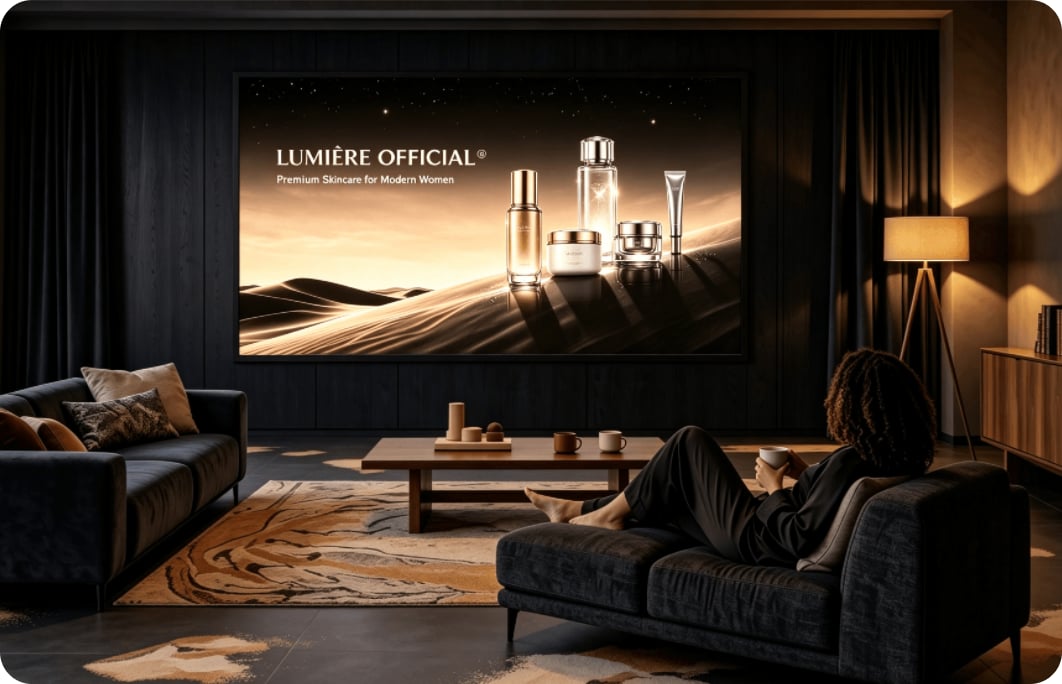
 单身女性广告
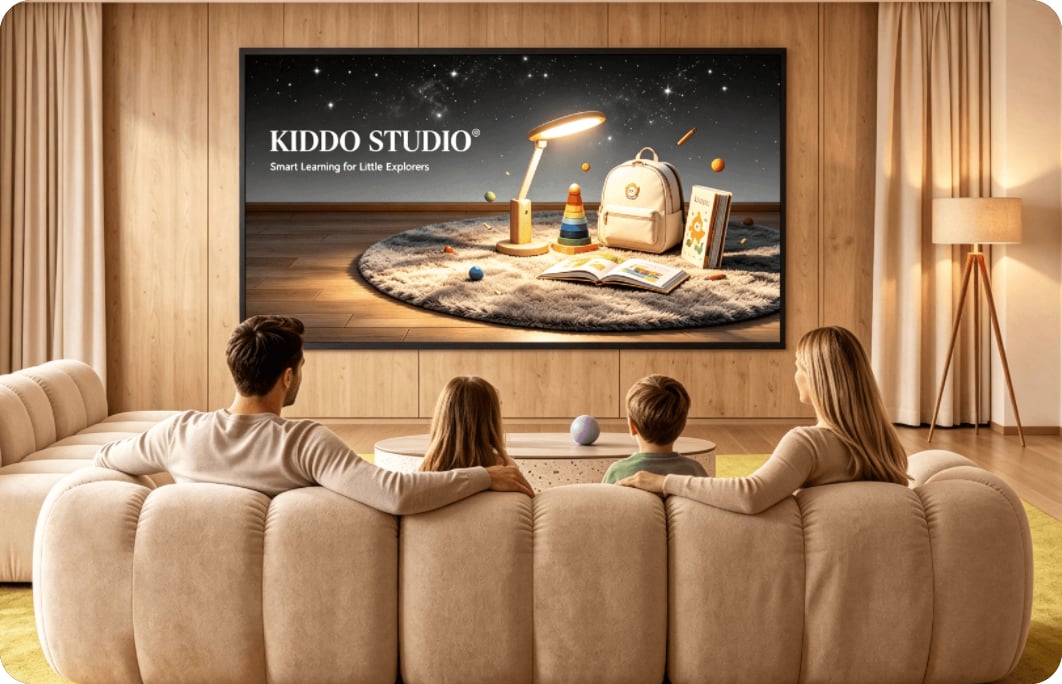 育儿家庭广告
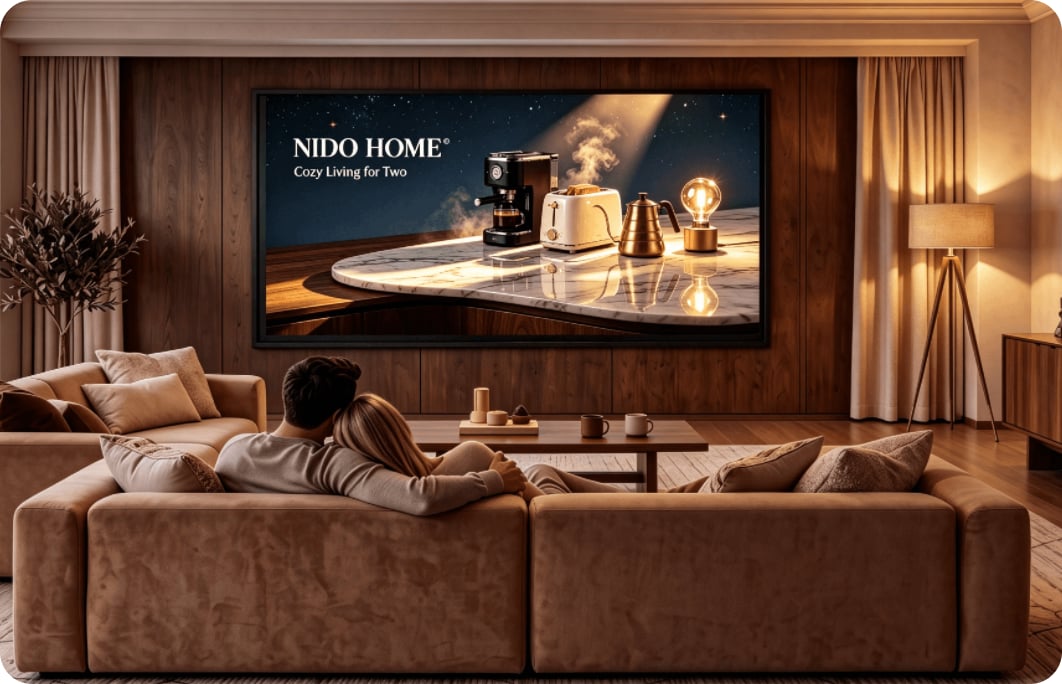 已婚伴侣广告
智能信号接入与协议转换
智能路径调度与容灾
直播流实时理解
实时画质增强与 4K 超分
服务端动态广告插入(SSAI)
数字水印与内容溯源
电商创作 Agent
顶级数据加持 轻轻松松就能用
800M+每日处理分钟数超 8 亿
90%+赋能领先的视频平台
20+yrs超 20 年技术与数据积累
No.1IDC 报告连续多年份额第一
在 Agent 中使用
无需对接 API,一句话让 Agent 自动安装并调用 WAND 全部能力。
请根据 https://skillhub.cn/install/skillhub.md,安装 @tencent-adm/tencent-mps-intl。
更多接入方式
一行命令完成安装,快速集成到本地工程与 CI 流水线。
命令行接入方式,即将开放
全球合规认证
让业务安心落地
 创造更好的世界
A one-stop media AI platform — from creation to delivery